框架
本文参考 JavaGuide
Spring
什么是Spring
Spring 是一款基于 Java 的轻量级开源开发框架,旨在提高开发人员的开发效率以及系统的可维护性。
Spring 框架(Spring Framework)是很多模块的集合,使用这些模块可以很方便地协助进行开发。Spring 支持控制反转(Inversion of Control, IOC) 和 面向切面编程(Aspect-Oriented Programming, AOP)、可以很方便地对数据库进行访问、可以很方便地集成第三方组件(电子邮件,任务,调度,缓存等等)、对单元测试支持比较好、支持 RESTful Java 应用程序的开发。
Spring的核心功能主要是 IoC 和 AOP,核心思想是不重新造轮子,开箱即用,提高开发效率。
Spring模块
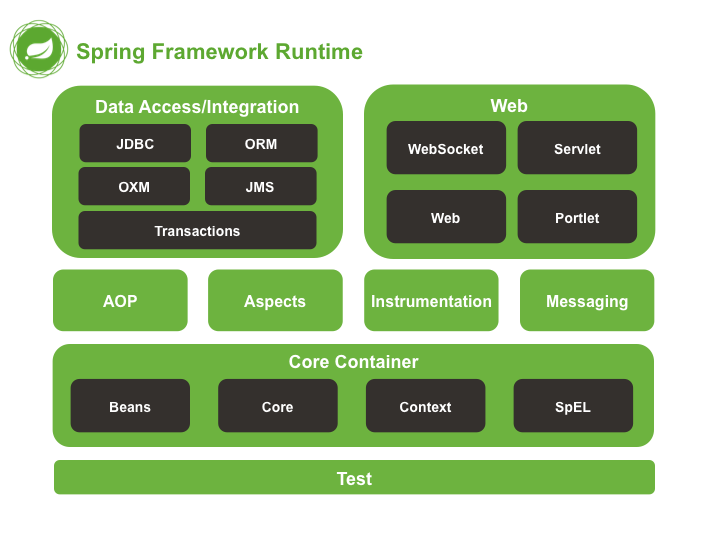
Spring5.x 版本中 Web 模块的 Portlet 组件已经被废弃掉,同时增加了用于异步响应式处理的 WebFlux 组件。
Core Container:Spring 框架的核心模块、基础模块,主要提供 IoC 依赖注入功能的支持。Spring 其他所有的功能基本都需要依赖于该模块。spring-core:Spring 框架基本的核心工具类。spring-beans:提供对bean的创建、配置和管理等功能的支持。spring-context:提供对国际化、事件传播、资源加载等功能的支持。spring-expression:提供对表达式语言(Spring Expression Language, SpEL)的支持,只依赖于core模块,不依赖于其他模块,可以单独使用。
AOP:面向切面编程,提供对切面编程的支持。spring-aop:提供了面向切面的编程实现。spring-aspects:该模块为与AspectJ的集成提供支持。spring-instrument:提供了为 JVM 添加代理(agent)的功能。其为 Tomcat 提供了一个织入代理,能够为 Tomcat 传递类文件,就像这些文件是被类加载器加载的一样。
Data Access/Integration:数据访问/集成层,提供对数据库访问、事务管理、ORM、OXM、JMS 等功能的支持。spring-jdbc:提供了对数据库访问的抽象 JDBC。不同的数据库都有自己独立的 API 用于操作数据库,而 Java 程序只需要和 JDBC API 交互,这样就屏蔽了数据库的影响。spring-tx:提供事务管理的支持。spring-orm:提供对 Hibernate、JPA、iBatis 等 ORM 框架的支持。spring-oxm:提供一个抽象层支撑 OXM(Object-to-XML-Mapping),如:JAXB、Castor、XMLBeans、JiBX 和 XStream 等。spring-jms:消息服务。自 Spring Framework 4.1 以后,它还提供了对spring-messaging模块的继承。
Spring Web:Web 模块,提供对 Web 应用开发的支持。spring-web:提供了基本的 Web 功能,如多文件上传、使用Servlet监听器初始化 Spring IoC 容器等。spring-webmvc:提供了 Spring MVC 的实现。spring-websocket:提供了对 WebSocket 的支持,可以让客户端和服务端进行双向通信。spring-webflux:提供对 WebFlux 的支持。WebFlux 是 Spring Framework 5.0 中引入的新的响应式框架。与 Spring MVC 不同,它不需要 Servlet API,是完全异步。
Messaging:spring-messaging是Spring4.0新加入的模块,主要职责是为 Spring 框架集成一些基础的报文传送应用。Spring Test:Spring有控制反转 (IoC)的帮助,单元测试和集成测试变得更简单。Spring 的测试模块对 JUnit(单元测试框架)、TestNG(类似 JUnit)、Mockito(主要用来 Mock 对象)、PowerMock(解决 Mockito 的问题比如无法模拟final,static,private方法)等等常用的测试框架支持的都比较好。
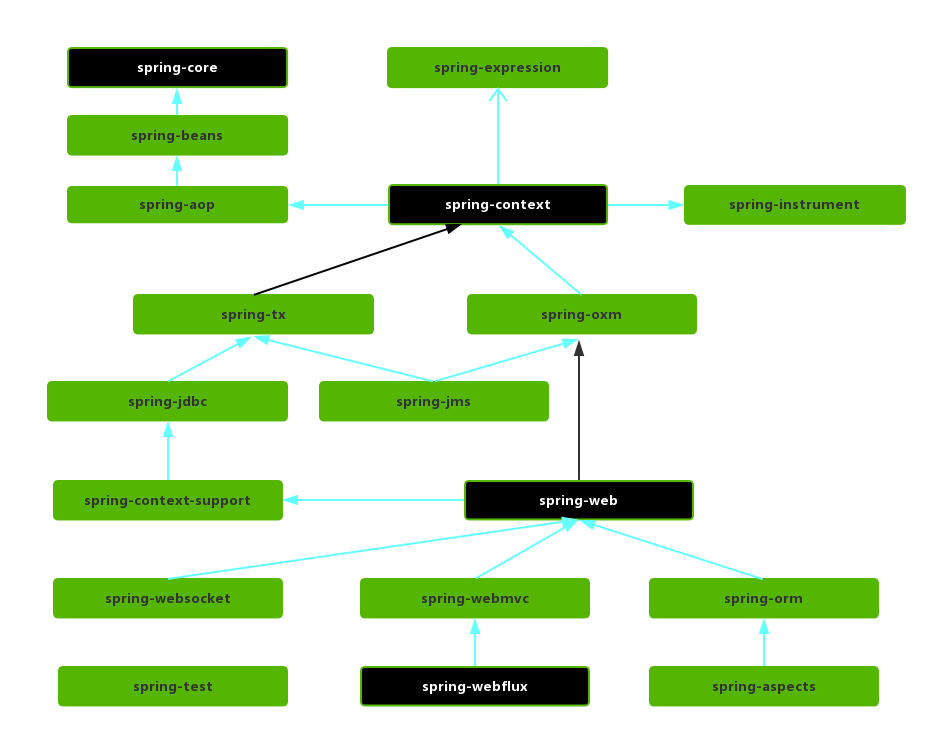
Spring/Spring Boot/Spring MVC之间的关系
- Spring是基于 Java 的轻量级开源框架,包含众多模块,其中最重要的是
Spring-Core(主要提供IoC依赖注入功能的支持)模块, Spring中的其他模块(如Spring MVC)的功能实现基本都需要依赖于该模块。 Spring MVC是 Spring 中的一个很重要的模块,主要赋予 Spring 快速构建 MVC 架构的 Web 程序的能力。MVC 是模型(Model)、视图(View)、控制器(Controller)的简写,其核心思想是通过将业务逻辑、数据、显示分离来组织代码。- 使用 Spring 进行开发各种配置过于麻烦比如开启某些 Spring 特性时,需要用 XML 或 Java 进行显式配置。过于麻烦,所以
Spring Boot诞生了,其只是简化了配置,如果需要构建 MVC 架构的 Web 程序,还是需要使用Spring MVC作为 MVC 框架,只是说Spring Boot简化了Spring MVC的很多配置,真正做到开箱即用!- Spring 旨在简化 J2EE 企业应用程序开发。
Spring Boot旨在简化 Spring 开发(减少配置文件,开箱即用!)。
- Spring 旨在简化 J2EE 企业应用程序开发。
Spring IoC✅
什么是Spring IoC
控制反转(Inversion of Control, IoC)是一种设计思想,而不是一个具体的技术实现,并非Spring特有。IoC 的思想就是将原本在程序中手动创建对象的控制权,交由 Spring 框架来管理。
现有类 A 依赖于类 B
- 传统的开发方式 :往往是在类 A 中手动通过
new关键字来 new 一个 B 的对象出来 - 使用 IoC 思想的开发方式 :不通过
new关键字来创建对象,而是通过 IoC 容器(Spring 框架) 来帮助我们实例化对象。我们需要哪个对象,直接从 IoC 容器里面去取即可。
IoC使开发者丧失了创建、管理对象的权利,但是也使得开发者不用再考虑对象的创建、管理等一系列的事情,只需要专注于业务逻辑的实现。
IoC解决了什么问题
- 依赖管理和解耦:在传统的Java应用中,类与类之间的依赖是通过硬编码实现的,这导致了代码的高度耦合和难以维护。Spring IoC通过依赖注入(Dependency Injection,DI)模式,将对象的创建和依赖关系的管理交给Spring容器处理,从而实现了组件之间的解耦,提升了代码的可维护性和可测试性。
- 对象生命周期管理:Spring容器负责管理Bean的生命周期,从创建、初始化到销毁,开发者可以通过配置和注解来控制这些生命周期方法,从而避免了手动管理对象生命周期的复杂性。
- 配置集中管理:通过Spring IoC,可以将应用程序的配置信息集中在一个或多个配置文件中(如XML文件、Java配置类或注解),从而使得配置更加集中和统一,便于管理和维护。
- 代码的可测试性:通过依赖注入,可以轻松地替换实际的依赖对象为模拟对象(mock objects),从而提高了单元测试的可行性和便捷性。
- 模块化和可插拔性:Spring IoC支持通过不同的配置方式(XML、注解、Java配置类等)来实现模块化配置,便于扩展和维护。同时,Spring IoC容器支持不同类型的Bean作用域(如单例、原型等),增强了系统的灵活性和可扩展性。
通过Spring IoC的依赖注入和面向接口编程的方式,开发者可以更加专注于业务逻辑的实现,而不必过多关心对象的创建和管理,从而提升了开发效率和代码质量。
Spring IoC原理
控制反转指将对象的创建和依赖关系的管理从应用程序代码中抽离出来,交给Spring容器进行管理。
控制反转
- 控制:指的是对象创建(实例化、管理)的权力
- 反转:控制权交给外部环境(Spring 框架、
IoC容器)
实现控制反转有多种方式:
- 依赖注入:通过注入方式实现依赖管理,易于测试和维护,广泛应用于现代开发框架(如Spring)。
- 服务定位器模式:通过中央注册器获取服务,使用方便,但可能引入全局状态和隐藏依赖。
- 事件驱动架构:通过事件进行解耦,适用于异步处理和复杂业务流程。
- 依赖查找:通过标准API查找依赖,适用于某些特定场景,但查找过程可能较为复杂。
Spring IoC容器
Spring IoC容器是负责管理对象及其依赖关系的核心组件。IoC 容器实际上就是个 Map(key,value),Map 中存放的是各种对象。主要的IoC容器有:
BeanFactory:最基础的IoC容器,提供基本的依赖注入功能。ApplicationContext:继承自BeanFactory,提供更多高级功能,如事件发布、国际化、AOP等。
什么是Spring Bean
在Spring中,bean是由IoC容器管理的对象。bean的定义和配置可以通过以下几种方式:
- XML配置文件:在XML文件中定义
bean及其依赖关系。 - 注解配置:通过Java注解(如
@Component、@Autowired等)定义和注入bean。 - Java配置类:使用
@Configuration和@Bean注解,通过Java类定义bean。
@Component/@Controller/@Service/@Repository区别
这四个注解本质上都属于组件注解,@Controller、@Service 和 @Repository 都基于 @Component 定义。被它们标注的类都可以被组件扫描发现,并注册为 Spring Bean,主要区别在于使用场景和附加能力:
@Component:通用组件注解。当一个类不明确属于控制层、业务层或持久层时,可以使用它。@Controller:用于控制层。Spring MVC 会识别其中的请求处理方法;如果接口需要直接返回 JSON,通常使用由@Controller和@ResponseBody组合而成的@RestController。@Service:用于业务逻辑层,主要表达类的职责,目前没有额外的特殊功能,但有助于提高代码可读性,也方便针对业务层统一配置 AOP。@Repository:用于持久层。除了表达分层语义,还可以配合 Spring 的异常转换机制,将不同持久化框架的异常转换为统一的DataAccessException体系。
一句话概括,这四个注解都能把类注册为 Bean,@Component 最通用,另外三个分别表示控制层、业务层和持久层,其中 @Repository 还可以参与持久化异常转换。
@Component/@Bean区别
主要区别
- 定义方式:
@Component是在类上使用,Spring 自动扫描并注册 Bean。@Bean是在方法上使用,返回值被注册为 Bean。
- 适用场景:
@Component适用于开发人员自己编写的类。@Bean适用于第三方库的类或需要复杂配置的 Bean。
- 扫描和配置:
@Component需要启用组件扫描。@Bean通常与配置类一起使用,不需要组件扫描。
总结来说,@Component 更适合于直接在类上进行标注,简化了配置过程;而 @Bean 则提供了更多的灵活性,可以在配置类中以编程的方式定义 Bean。
@Component
- 用途:
@Component用于标记一个类为 Spring 容器的组件(Bean)。 - 使用方式:直接在类上使用。Spring 会自动扫描带有
@Component注解的类,并将其注册为 Spring 容器中的 Bean。 - 扫描:需要在配置类上使用
@ComponentScan注解来启用自动扫描。 - 适用范围:通常用于标记服务层、数据访问层、控制层等组件类。
- 例子:@Bean
public class MyService {
// 服务实现
} - 用途:
@Bean用于在配置类中定义一个方法,该方法的返回值会被注册为 Spring 容器中的 Bean。 - 使用方式:在配置类的方法上使用,方法的返回值会作为 Bean 注册到 Spring 容器中。
- 配置类:通常与
@Configuration注解一起使用,表明这是一个配置类。 - 适用范围:通常用于定义第三方库的 Bean,或者需要复杂初始化的 Bean。
- 例子:
public class AppConfig {
public MyService myService() {
return new MyServiceImpl();
}
}
用于注入Bean的注解有哪些?
Spring 中常用的 Bean 注入注解有 @Autowired、@Resource 和 @Inject,三者都能完成依赖注入,但来源和匹配规则不同。
@Autowired:Spring 提供的注解,默认按类型查找 Bean,可以标注在构造方法、字段、Setter 方法和普通方法上。如果同一类型存在多个 Bean,可以配合@Qualifier缩小候选范围,或者通过@Primary指定首选 Bean。从 Spring 4.3 开始,类中只有一个构造方法时可以省略@Autowired。@Resource:JSR-250 提供的注解,主要用于字段和 Setter 方法。未指定name时,Spring 会先按字段名或属性名匹配 Bean,匹配不到再按类型查找;显式指定name后,则按照该名称查找。@Inject:JSR-330 提供的注解,在 Spring 中的用法与@Autowired基本一致,也可以配合@Named或@Qualifier筛选候选 Bean,但它没有required=false这一属性。
@Qualifier 和 @Primary 本身不负责触发依赖注入,而是在存在多个同类型 Bean 时帮助 Spring 选择候选对象。@Qualifier 表示进一步限定,@Primary 表示没有其他限定条件时优先选择。
实际开发更推荐构造器注入,因为依赖关系明确,也更方便测试。例如:
|
另外,@Value 主要用于注入配置属性或 Spring EL 表达式的计算结果,不属于典型的 Bean 注入注解,不应与上面三者混为一谈。
一句话概括,@Autowired、@Resource 和 @Inject 负责注入依赖,@Qualifier、@Primary 负责解决候选 Bean 的选择问题,@Value 则主要负责注入配置值。
@Autowired/@Resource区别
- 默认注入方式:
@Autowired默认根据接口类型(byType)去匹配并注入Bean(接口的实现类)。当一个接口存在多个实现类的话,Autowired可以通过@Qualifier注解来显式指定类名称。@Resource当一个接口存在多个实现类的话,默认按类名称(byName)注入。如果无法通过名称匹配到对应的 Bean 的话,注入方式会变为byType。
- 注解来源:
@Autowired:Spring 框架提供的注解。@Resource:JSR-250(JDK) 标准提供的注解。
- 使用位置:
@Autowired可以用在构造函数、方法、字段以及参数上。@Resource通常用在字段和 Setter 方法上的注入。
- 配置属性:
@Autowired:可以结合@Qualifier按名称注入。@Resource:可以通过name属性指定Bean名称,通过type属性指定 Bean 类型。
- 处理机制:
@Autowired:使用 Spring 的依赖注入机制。@Resource:使用 JNDI 进行资源查找,适合在 Java EE 容器环境中使用。
总的来说,@Autowired 更加灵活和强大,适合在 Spring 应用中广泛使用;而 @Resource 则提供了一种更标准化的方式进行依赖注入,特别是在需要与 Java EE 容器进行集成时。
@Resource有两个比较重要且日常开发常用的属性:name(名称)、type(类型)。
String name() default "";
Class<?> type() default Object.class;
}如果仅指定
name属性则注入方式为byName,如果仅指定type属性则注入方式为byType,如果同时指定name和type属性(不建议这么做)则注入方式为byType+byName。
Bean的作用域有哪些?
在 Spring 框架中,Bean 的作用域(scope)定义了 Bean 的生命周期和可见性。Spring 提供了以下几种常见的 Bean 作用域:
Singleton- 描述:默认作用域。在整个 Spring 容器中只有一个 Bean 实例,每次请求该 Bean 时都会返回同一个实例。
- 使用场景:大多数情况下使用,适用于无状态的 Bean。
Prototype- 描述:每次请求该 Bean 时,都会创建一个新的实例。
- 使用场景:适用于有状态的 Bean 或需要每次使用时创建新实例的 Bean。
Request- 描述:在一个 HTTP 请求中,每次请求该 Bean 时,都会创建一个新的实例。该作用域仅在 Web 应用程序中有效。
- 使用场景:适用于每个 HTTP 请求需要一个独立 Bean 实例的情况,例如处理用户请求的控制器。
Session- 描述:在一个 HTTP 会话中,每次请求该 Bean 时,都会返回同一个实例。该作用域仅在 Web 应用程序中有效。
- 使用场景:适用于需要在整个用户会话期间保持状态的 Bean。
Global Session- 描述:在一个全局 HTTP 会话中,每次请求该 Bean 时,都会返回同一个实例。该作用域主要用于 Portlet 应用程序。
- 使用场景:适用于需要在全局 Portlet 会话期间保持状态的 Bean。
Application- 描述:在整个应用程序生命周期内,每次请求该 Bean 时,都会返回同一个实例。通常在 Web 应用程序中使用。
- 使用场景:适用于需要在整个应用程序生命周期内共享的 Bean。
// Scope中可以指定Bean的作用域,取值:singleton、prototype、request、session、globalSession、application |
Bean是线程安全的吗
在 Spring 框架中,Bean 的线程安全性取决于其作用域和状态。以下是一些常见情况:
Singleton Bean
- 默认作用域:
@Scope("singleton") - 描述:单例 Bean 在 Spring 容器中只有一个实例,并且该实例会被多个线程共享。
- 线程安全性:单例 Bean 本身并不是线程安全的。如果单例 Bean 中包含可变的共享状态,则需要确保其线程安全。这可以通过以下方式实现:
- 不在单例 Bean 中使用可变状态。
- 使用线程安全的数据结构(如
ConcurrentHashMap)。 - 在访问可变状态时使用同步(如
synchronized)。 - 采用无状态的设计模式。
Prototype Bean
- 作用域:
@Scope("prototype") - 描述:原型 Bean 每次请求时都会创建一个新的实例,因此每个线程都会获得一个新的实例。
- 线程安全性:由于每个线程都有自己的实例,原型 Bean 通常是线程安全的。但是,原型 Bean 的生命周期由使用它的对象管理,可能需要注意其创建和销毁的时机。
Request & Session Scoped Beans
- 作用域:
@Scope("request")和@Scope("session") - 描述:请求作用域的 Bean 在一个 HTTP 请求中创建和销毁。会话作用域的 Bean 在一个 HTTP 会话中创建和销毁。
- 线程安全性:请求作用域的 Bean 通常是线程安全的,因为每个请求都是独立的。会话作用域的 Bean 可能会被多个线程共享,需要考虑线程安全性。
Application Scoped Beans
- 作用域:
@Scope("application") - 描述:应用程序作用域的 Bean 在整个应用程序生命周期内共享。
- 线程安全性:与单例 Bean 类似,应用程序作用域的 Bean 需要注意线程安全性问题。
Global Session Scoped Beans
- 作用域:
@Scope("globalSession") - 描述:全局会话作用域的 Bean 在 Portlet 应用程序的全局会话中共享。
- 线程安全性:类似于会话作用域的 Bean,需要考虑线程安全性。
总之,除非 Bean 的设计明确考虑了线程安全性,否则默认情况下 Spring 容器不会保证 Bean 的线程安全。确保线程安全的最佳实践包括无状态设计、使用线程安全的数据结构以及适当的同步机制。
Bean的生命周期
- 创建 Bean 的实例:Bean 容器首先会找到配置文件中的 Bean 定义,然后使用 Java 反射 API 来创建 Bean 的实例。
- Bean 属性填充(依赖注入):为 Bean 设置相关属性和依赖,如
@Autowired等注解注入的对象、@Value注入的值、setter方法或构造函数注入依赖和值、@Resource注入的各种资源。 - Bean的初始化
- 调用
Aware接口的方法:- 如果 Bean 实现了
BeanNameAware接口,调用setBeanName()方法,传入 Bean 的名字。 - 如果 Bean 实现了
BeanClassLoaderAware接口,调用setBeanClassLoader()方法,传入ClassLoader对象的实例。 - 如果 Bean 实现了
BeanFactoryAware接口,调用setBeanFactory()方法,传入BeanFactory对象的实例。 - 如果实现了其他 *.Aware接口,就调用相应的方法。
- 如果 Bean 实现了
- 前置处理:如果有和加载这个 Bean 的 Spring 容器相关的
BeanPostProcessor对象,执行postProcessBeforeInitialization()方法 - 初始化方法:如果 Bean 实现了
InitializingBean接口,执行afterPropertiesSet()方法。如果 Bean 在配置文件中的定义包含init-method属性,执行指定的方法。 - 后置处理:如果有和加载这个 Bean 的 Spring 容器相关的
BeanPostProcessor对象,执行postProcessAfterInitialization()方法。
- 调用
- 使用 Bean:Bean 可以被容器使用了,可以调用 Bean 的方法处理业务逻辑。
- 销毁 Bean:销毁并不是立马把 Bean 给销毁掉,而是把 Bean 的销毁方法先记录下来,将来需要销毁 Bean 或者销毁容器的时候,就调用这些方法去释放 Bean 所持有的资源。
- 如果 Bean 实现了
DisposableBean接口,执行destroy()方法。 - 如果 Bean 在配置文件中的定义包含
destroy-method属性,执行指定的 Bean 销毁方法。 - 也可以直接通过
@PreDestroy注解标记 Bean 销毁之前执行的方法。
- 如果 Bean 实现了
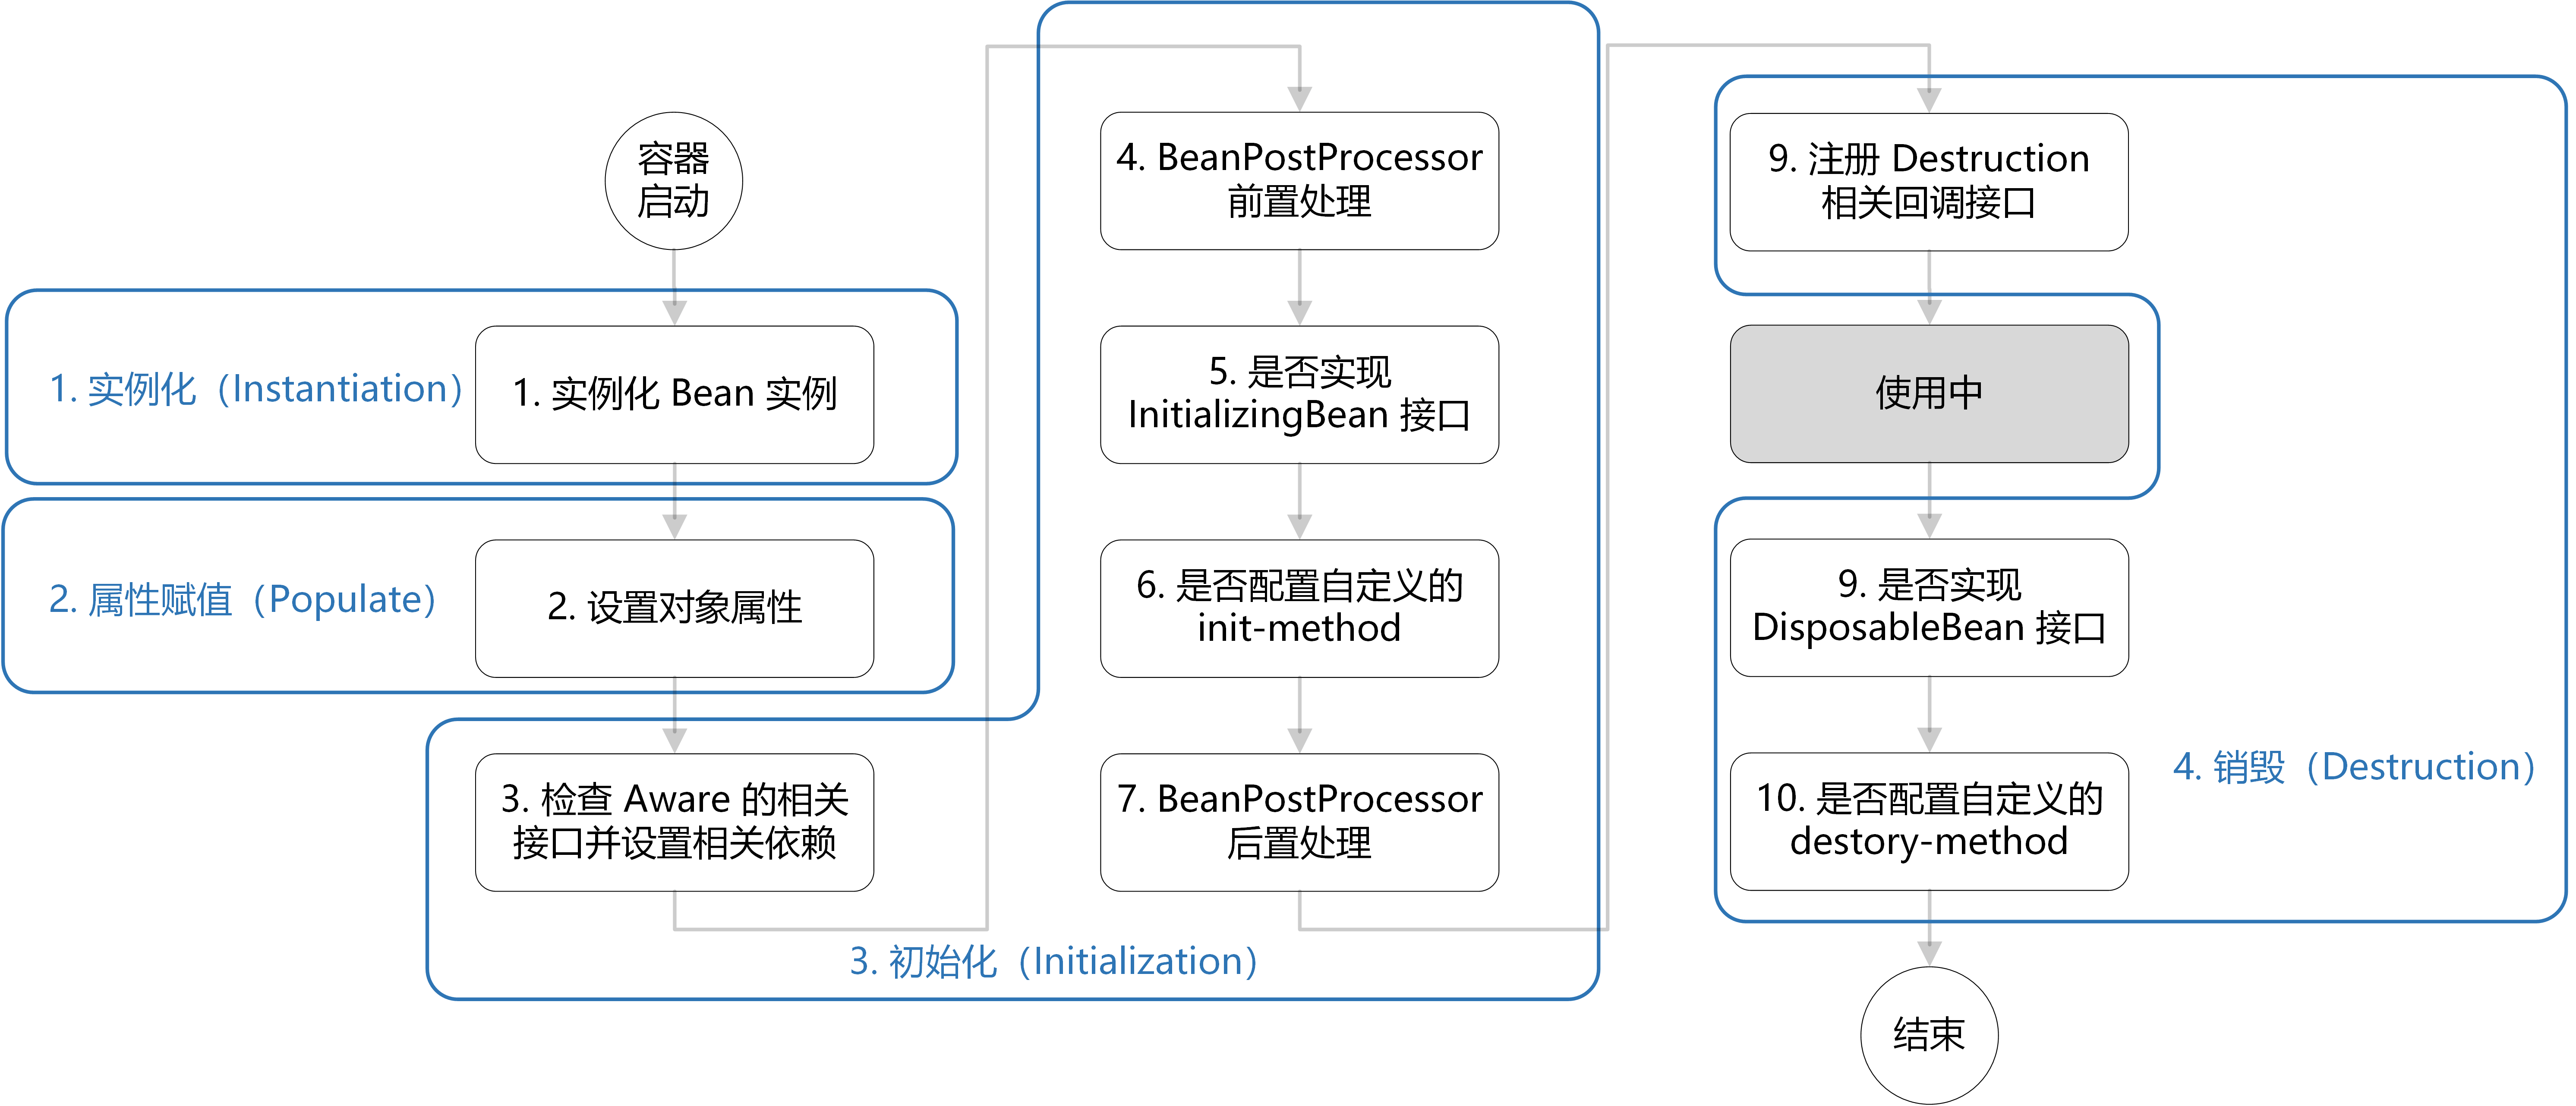
Spring 中提供的 Aware 接口主要有:
BeanNameAware:注入当前bean对应beanName;BeanClassLoaderAware:注入加载当前bean的ClassLoader;BeanFactoryAware:注入当前BeanFactory容器的引用。
Spring AOP✅
对Spring AOP的理解
面向切面编程(Aspect-Oriented Programming, AOP)是面向对象编程(OOP)的补充。它把日志、事务、权限、监控等分散在各个业务方法中的横切逻辑抽成切面,在不修改核心业务代码的前提下统一增强方法,从而减少重复代码和模块耦合。
Spring AOP 的核心是运行时代理:容器保存的通常不是原始对象,而是代理对象。外部调用先进入代理,由代理匹配切点,再以嵌套方式推进拦截器链;链尾调用目标方法,返回时再执行对应的返回、异常或后置逻辑。Spring 也支持 AspectJ 注解风格,但使用 @Aspect 并不代表采用了 AspectJ 字节码织入,Spring AOP 默认仍然是代理机制。
Spring AOP两种实现方式
口述版
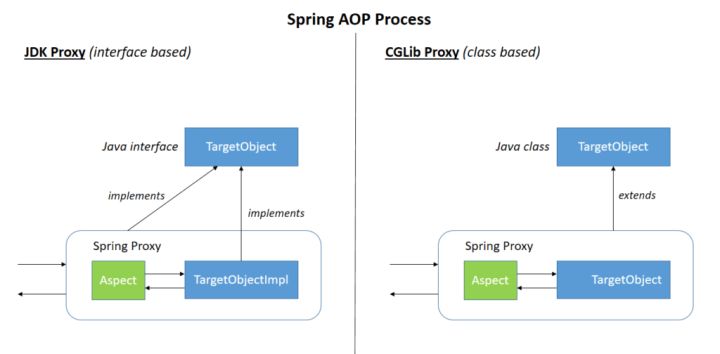
Spring AOP 有 JDK 动态代理和 CGLIB 代理两种实现。
- JDK 动态代理基于接口,运行时通过
Proxy和InvocationHandler生成接口的代理对象; - CGLIB 基于继承,运行时生成目标类的子类并重写可代理的方法,在方法调用前后执行增强。两者本质都是让调用先经过代理,再进入目标方法。
JDK 代理要求从接口类型调用,CGLIB 不要求目标类实现接口,但不能代理 final 类,也不能重写 final、private、static 方法。需要注意,Spring Boot 2.x 以后默认倾向使用 CGLIB;在普通 Spring 中,具体选择还要看 proxyTargetClass 配置和目标类是否提供接口。
详细原理版
- JDK 动态代理:
Proxy.newProxyInstance()根据目标对象实现的接口生成代理类,代理方法统一进入InvocationHandler#invoke()。Spring 在这里匹配Advisor,组织拦截器链,执行通知后再通过反射调用目标方法。代理对象与目标对象实现相同接口,但不是目标类的子类,因此只能代理接口中暴露的方法。 - CGLIB 代理:Spring 使用 CGLIB 的
Enhancer为目标类生成子类,子类重写可代理方法,并把调用交给MethodInterceptor。它不要求目标类实现接口,适合直接按具体类注入的场景。 - 选择规则:普通 Spring 中,如果明确设置
proxyTargetClass=true、没有可代理接口或要求类代理,通常使用 CGLIB;否则可以使用 JDK 动态代理。Spring Boot 默认配置spring.aop.proxy-target-class=true,所以多数 Boot 项目默认看到的是 CGLIB 代理。 - 共同限制:两种方式都依赖“通过代理对象发起调用”。同一个类中使用
this调用另一个增强方法时,调用没有重新经过代理,因此事务、缓存、异步等通知可能不生效。
CGLIB详细原理
口述版
CGLIB 的核心思路是“动态生成子类”。Spring 在运行时为目标类生成代理子类,重写其中可以被覆盖的方法。调用代理方法时会先进入 MethodInterceptor,Spring 在这里执行事务、日志等拦截器链,然后再调用目标方法。为了减少普通反射的开销,CGLIB 会为方法建立索引,并通过 FastClass、MethodProxy 完成快速分派。因为它依赖继承和方法重写,所以 final 类不能被代理,final、private、static 方法也不能被增强;此外,自调用仍然绕过 Spring 的代理链。
详细原理版
- 发现增强规则:Spring 创建 Bean 时,
AbstractAutoProxyCreator一类的后置处理器会查找与该 Bean 匹配的Advisor,其中包含切点和通知。 - 创建代理子类:如果选择 CGLIB,Spring 通过
Enhancer以目标类为父类生成新的字节码。Spring Framework 已经把 CGLIB 重新打包到spring-core中,一般不需要单独引入 CGLIB 依赖。 - 重写目标方法:生成的子类会重写非
final且可见的方法,并为不同类型的调用配置回调。普通增强方法通常进入 Spring 的DynamicAdvisedInterceptor。 - 执行拦截器链:代理收到调用后,根据当前方法查找并按优先级组织匹配的
Advisor。各拦截器以嵌套调用的方式执行,返回通知只在正常返回后执行,异常通知只在抛出匹配异常时执行,最终由链尾调用目标方法。 - 快速方法分派:CGLIB 会生成
FastClass,把方法签名映射为整数索引,再通过索引定位方法,避免每次都走完整的Method.invoke()反射查找流程。这里优化的是方法分派过程,不改变代理仍需执行拦截器链的事实。 - 返回代理 Bean:代理对象替换原始 Bean 暴露到 Spring 容器中。只有调用方拿到并调用这个代理对象,增强逻辑才有机会执行。
CGLIB 的边界也来自这套设计:类被 final 修饰时无法生成子类;方法被 final 修饰时无法重写;private 方法对子类不可见;static 方法属于类而不是实例。这些方法即使写了切点或 @Transactional,也不会按预期进入 Spring AOP 拦截器链。
AOP解决了什么问题
- 横切关注点分离:在传统的面向对象编程中,某些功能(如日志记录、事务管理、安全性验证等)往往分散在多个类和方法中,导致代码的重复和耦合。AOP通过将这些横切关注点独立出来,以切面的形式进行集中管理,从而简化了核心业务逻辑。
- 提高代码可读性和可维护性:通过将横切关注点分离出来,核心业务代码变得更加简洁、清晰。这样,开发者可以更加专注于业务逻辑的实现,提高代码的可读性和可维护性。
- 动态代理和拦截功能:AOP提供了动态代理机制,可以在不修改原有代码的情况下,对方法进行拦截和增强。这种机制在处理权限验证、性能监控、缓存管理等场景时非常有用。
- 代码重用:由于横切关注点可以以独立的切面形式存在,可以在不同的应用和模块之间共享和重用,提高了代码的复用性。
- 减少代码耦合:通过AOP,将横切关注点从业务逻辑中分离出来,使得各个模块之间的耦合度降低,从而提高了系统的灵活性和可扩展性。
AOP应用场景
- 日志记录:可以在方法执行前后自动记录日志,而不需要在每个方法中手动添加日志代码。
- 事务管理:可以在方法开始时开启事务,方法结束时提交或回滚事务,确保数据一致性。
- 安全性验证:可以在方法执行前进行权限验证,确保用户有权限执行该操作。
- 性能监控:可以统计方法的执行时间,进行性能分析和优化。
- 异常处理:可以统一处理方法中的异常,避免重复的异常处理代码。
Spring AOP原理
Spring AOP(面向切面编程)是Spring框架中的一个重要模块,用于在不修改现有代码的情况下向程序中添加新的行为。基本原理和关键概念如下:
- 核心概念
- Target(目标):被通知的对象
- Proxy(代理):向目标对象应用通知之后创建的代理对象
- Join Point(连接点):目标对象的所属类中,定义的所有方法均为连接点
- Pointcut(切点):切点是用于匹配连接点的表达式。被切面拦截 / 增强的连接点(切入点一定是连接点,连接点不一定是切入点)
- Advice(通知):增强的逻辑 / 代码,也即拦截到目标对象的连接点之后要做的事情。Spring AOP支持五种类型的通知:前置通知(Before)、后置通知(After)、返回通知(AfterReturning)、异常通知(AfterThrowing)和环绕通知(Around)。
- Aspect(切面):切面是AOP的核心概念。切入点(Pointcut)+通知(Advice)。
- Weaving(织入):将通知应用到目标对象,进而生成代理对象的过程动作。Spring AOP在运行时通过动态代理实现织入。
- 实现机制
Spring AOP主要通过两种方式来实现AOP功能:- JDK动态代理:适用于基于接口的代理。Spring AOP使用JDK动态代理来创建实现了一个或多个接口的代理对象。
- CGLIB代理:适用于没有实现接口的类。Spring AOP使用CGLIB库生成目标类的子类来实现代理。
- 工作流程
- 定义切面和通知:使用
@Aspect注解定义切面,并在切面类中使用@Before、@After等注解定义通知。 - 配置AOP:在Spring配置文件中启用AOP支持,或使用
@EnableAspectJAutoProxy注解来启用AOP自动代理。 - 应用切面:Spring容器根据配置和切点表达式在运行时生成代理对象,并将通知织入到目标方法的执行中。
- 定义切面和通知:使用
Spring AOP的核心在于通过动态代理和切点表达式,实现了对横切关注点的模块化管理,使得代码更易于维护和扩展。
// 定义切面 |
在示例中,定义了一个LoggingAspect切面,其中包含前置通知和后置通知。然后,在Spring配置中启用了AOP支持,并将切面类注册为Bean。Spring容器将在运行时生成代理对象,并在目标方法执行前后执行通知。
Spring AOP/AspectJ AOP区别
- 实现方式
- Spring AOP:基于代理机制(Proxy-based),主要使用JDK动态代理和CGLIB动态代理。属于运行时增强
- AspectJ AOP:基于字节码操作(Bytecode Manipulation),通过编译时、加载时和运行时织入(Weaving)实现。属于编译时增强
- 功能
- Spring AOP:只支持方法级别的AOP。
- AspectJ AOP:提供更强大的功能和更高的性能,适用于类级别和方法级别的AOP。
- 性能
- Spring AOP:由于基于代理机制,性能相对较低,适用于大多数应用场景,但在高性能要求的场景中可能不够高效。
- AspectJ AOP:由于直接操作字节码,性能较高,适用于对性能要求较高的应用场景。
- 配置和使用
- Spring AOP:配置相对简单,使用Spring的注解和配置文件即可实现。适用于已经使用Spring框架的应用,容易集成和使用。
- AspectJ AOP:配置较为复杂,需要AspectJ编译器或AspectJ加载时编织器。需要对AspectJ的语法和配置有一定了解,适用于需要更强大AOP功能的应用。
- 使用场景
- Spring AOP:适用于大多数Spring应用,特别是那些只需要方法级别AOP的场景。
- AspectJ AOP:适用于需要更强大AOP功能、更高性能和更细粒度控制的场景。
如果项目已经在使用Spring框架并且AOP需求较为简单,Spring AOP是一个不错的选择;如果需要更强大和高性能的AOP功能,AspectJ AOP是更好的选择。
AspectJ AOP的五种通知类型
- Before(前置通知):目标对象的方法调用之前触发
- After (后置通知):目标对象的方法调用之后触发
- AfterReturning(返回通知):目标对象的方法调用完成,在返回结果值之后触发
- AfterThrowing(异常通知):目标对象的方法运行中抛出 / 触发异常后触发。AfterReturning 和 AfterThrowing 两者互斥。如果方法调用成功无异常,则会有返回值;如果方法抛出了异常,则不会有返回值。
- Around (环绕通知):编程式控制目标对象的方法调用。环绕通知是所有通知类型中可操作范围最大的一种,因为它可以直接拿到目标对象,以及要执行的方法,所以环绕通知可以任意的在目标对象的方法调用前后搞事,甚至不调用目标对象的方法
多个切面的执行顺序如何控制
通常使用
@Order注解直接定义切面顺序// 值越小优先级越高
public class LoggingAspect implements Ordered {实现
Ordered接口重写getOrder方法。
public class LoggingAspect implements Ordered {
// ....
public int getOrder() {
// 返回值越小优先级越高
return 1;
}
}
SpringMVC✅
MVC 是一种设计模式,Spring MVC 是一款很优秀的 MVC 框架。Spring MVC 可以帮助我们进行更简洁的 Web 层的开发,并且它天生与 Spring 框架集成。Spring MVC 下我们一般把后端项目分为 Service 层(处理业务)、Dao 层(数据库操作)、Entity 层(实体类)、Controller 层(控制层,返回数据给前台页面)。
MVC核心组件
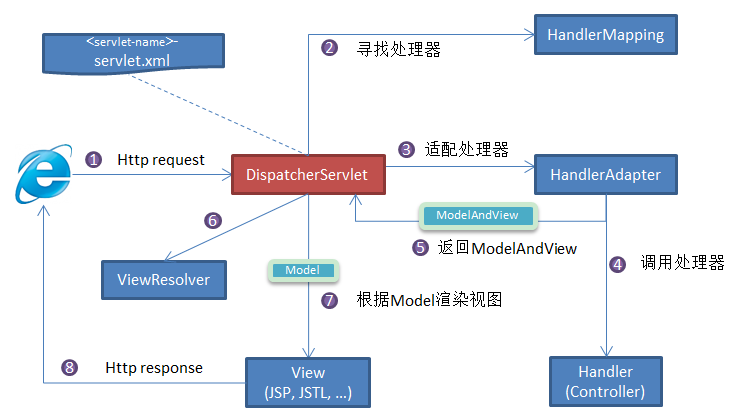
DispatcherServlet:核心的中央处理器,负责接收请求、分发,并给予客户端响应。HandlerMapping:处理器映射器,根据 URL 去匹配查找能处理的Handler,并会将请求涉及到的拦截器和Handler一起封装。HandlerAdapter:处理器适配器,根据HandlerMapping找到的Handler,适配执行对应的Handler;Handler:请求处理器,处理实际请求的处理器。ViewResolver:视图解析器,根据Handler返回的逻辑视图 / 视图,解析并渲染真正的视图,并传递给DispatcherServlet响应客户端
SpringMVC工作原理
流程
- 客户端(浏览器)发送请求,
DispatcherServlet拦截请求。 DispatcherServlet根据请求信息调用HandlerMapping。HandlerMapping根据 URL 去匹配查找能处理的Handler(也就是Controller控制器) ,并会将请求涉及到的拦截器和Handler一起封装。DispatcherServlet调用HandlerAdapter适配器执行Handler。Handler完成对用户请求的处理后,会返回一个ModelAndView对象给DispatcherServlet,ModelAndView顾名思义,包含了数据模型以及相应的视图的信息。Model是返回的数据对象,View是个逻辑上的View。ViewResolver会根据逻辑View查找实际的View。DispaterServlet把返回的Model传给View(视图渲染)。- 把
View返回给请求者(浏览器)
过滤器和拦截器都能拦请求,为何还要分开用
过滤器和拦截器处于不同的执行层级,能获取的信息也不同,因此适合承担不同职责:
Filter属于 Servlet 规范,由 Servlet 容器管理,执行位置在DispatcherServlet之前。它能处理映射范围内的 Servlet 请求,但通常不知道请求最终对应哪个 Controller 方法,适合处理跨域、字符编码、请求包装、响应压缩等与具体业务接口无关的通用逻辑。Interceptor属于 Spring MVC,执行位置在DispatcherServlet内部。它不仅能拿到请求和响应,还能获取当前处理器;当处理器是HandlerMethod时,还可以知道具体的 Controller、方法及其注解,适合登录校验、权限判断、接口审计和耗时统计等需要感知业务接口的逻辑。
二者的执行顺序大致如下:
Filter 前置逻辑 |
所以项目中通常把底层、通用、与 Spring MVC 无关的能力放到过滤器中,把需要感知 Controller 方法或注解的接口级控制放到拦截器中。二者不是重复实现,而是在不同层级各司其职。
一句话概括,过滤器拦得更早、范围更广,拦截器离业务更近、控制粒度更细。
Spring框架中用到了哪些设计模式
- **工厂模式 (Factory Pattern)**:
- Spring 使用工厂模式来创建对象实例。
BeanFactory和ApplicationContext是 Spring 中的两种主要的工厂类,用于管理和创建 bean 对象。BeanFactory:延迟注入(使用到某个 bean 的时候才会注入),相比于ApplicationContext来说会占用更少的内存,程序启动速度更快。ApplicationContext:容器启动的时候,不管用没用到,一次性创建所有 bean 。BeanFactory仅提供了最基本的依赖注入支持,ApplicationContext扩展了BeanFactory,除了有BeanFactory的功能还有额外更多功能,所以一般开发人员使用ApplicationContext会更多。
- Spring 使用工厂模式来创建对象实例。
- **单例模式 (Singleton Pattern)**:
- 默认情况下,Spring 容器中的 bean 是单例的,这意味着在整个 Spring 容器中只有一个 bean 实例存在。这通过 Spring 的 IoC 容器来管理。
- **代理模式 (Proxy Pattern)**:
- Spring AOP (Aspect-Oriented Programming) 使用代理模式来实现横切关注点(如事务管理、日志记录等)的分离。Spring 提供了 JDK 动态代理和 CGLIB 代理两种方式。
- **模板模式 (Template Method Pattern)**:
- Spring 中的模板类(如
JdbcTemplate,RestTemplate)通过封装一系列的操作步骤,简化了数据库操作和 REST 调用等重复性的编程任务。
- Spring 中的模板类(如
- **依赖注入模式 (Dependency Injection Pattern)**:
- 依赖注入是 Spring 的核心设计模式,通过构造器注入、setter 注入和接口注入等方式,实现了对象之间的松耦合。
- **观察者模式 (Observer Pattern)**:
- Spring 事件机制使用了观察者模式。可以通过
ApplicationEvent和ApplicationListener在应用程序中发布和监听事件。
- Spring 事件机制使用了观察者模式。可以通过
- **适配器模式 (Adapter Pattern)**:
- Spring AOP 的实现是基于代理模式,但是 Spring AOP 的增强或通知(Advice)使用到了适配器模式,与之相关的接口是
AdvisorAdapter。 - Spring MVC 中的
HandlerAdapter用于适配不同类型的处理器方法,使得这些方法可以作为统一的处理器进行调用。
- Spring AOP 的实现是基于代理模式,但是 Spring AOP 的增强或通知(Advice)使用到了适配器模式,与之相关的接口是
- **策略模式 (Strategy Pattern)**:
- Spring 中的某些功能(如事务管理)使用了策略模式,允许在运行时选择具体的实现策略。
- **装饰者模式 (Decorator Pattern)**:
- Spring 的
BeanPostProcessor和BeanFactoryPostProcessor用于在 bean 初始化前后进行一些自定义的处理,这实际上是对原有 bean 的功能进行扩展和增强。
- Spring 的
这些设计模式的使用,使得 Spring 框架具备高度的灵活性、可扩展性和可维护性。
BeanFactory/ApplicationContext区别
功能:
BeanFactory是Spring的核心接口,提供了基本的IOC(Inversion of Control)容器功能,负责实例化、配置和管理bean。ApplicationContext是BeanFactory的子接口,扩展了更多的企业级功能,如事件机制、国际化支持、AOP(面向切面编程)集成、Web应用上下文等。
初始化:
BeanFactory采用懒加载机制,只有在第一次访问某个bean时,才会实例化该bean。这对启动性能有好处,但可能会导致首次访问时的延迟。ApplicationContext预初始化:其在启动时会预先实例化所有单例bean,确保在应用启动时所有必要的bean已经准备好。这有助于捕获配置问题并提升应用的响应速度。
使用场景:
BeanFactory适用于资源受限的环境,如移动设备或嵌入式系统,适用于对性能要求高且对Spring的高级功能需求较少的应用。ApplicationContext适用于标准的企业级应用中,特别是Web应用,适用于需要Spring框架提供的所有功能和高级特性的应用。
依赖查找:
BeanFactory依赖于显式的查找,开发者需要通过getBean方法手动获取bean。ApplicationContext除了显式查找外,还支持自动注入和其他更加灵活的依赖管理方式。
如果应用需要完整的Spring功能,包括事件发布、国际化、AOP支持以及其他企业级特性,使用
ApplicationContext。如果应用在一个资源受限的环境中运行并且只需要基本的IOC容器功能,
BeanFactory可能更合适。
通常在实际的Spring应用开发中,大多数开发者会选择使用ApplicationContext,因为它提供了更丰富的功能和更好的开发体验。
Spring循环依赖及解决方案
在Spring框架中,循环依赖是指两个或多个bean之间相互依赖,导致无法正常实例化的问题。例如,Bean A依赖Bean B,而Bean B又依赖Bean A。这种情况下,Spring容器无法确定先实例化哪个bean,从而陷入死循环。
Spring主要通过三级缓存解决循环依赖:
如果发生循环依赖的话,就去 三级缓存 singletonFactories 中拿到三级缓存中存储的 ObjectFactory 并调用它的 getObject() 方法来获取这个循环依赖对象的前期暴露对象(虽然还没初始化完成,但是可以拿到该对象在堆中的存储地址了),并且将这个前期暴露对象放到二级缓存中,这样在循环依赖时,就不会重复初始化了!
循环依赖的问题主要有两种情况:
- 构造函数循环依赖:构造函数循环依赖指的是两个bean在构造函数中相互依赖。这种情况由于在实例化bean时必须提供构造函数的参数,所以Spring无法解决这种类型的循环依赖。
- 将构造函数注入改为setter注入:Setter注入是解决循环依赖的常用方法。Spring能够在实例化一个bean并将其放入singleton池后,通过setter方法注入其他bean的依赖。
- 使用
@Lazy注解:@Lazy注解可以延迟bean的初始化,直到真正需要该bean时才进行实例化,从而打破循环依赖。 - 使用接口和代理:使用Spring AOP可以创建代理对象,从而打破循环依赖。通过AOP,Spring可以创建一个代理对象来代替实际的bean,这样即使两个bean相互依赖,Spring也能处理。
- Setter循环依赖:Setter循环依赖指的是两个bean通过setter方法相互依赖。Spring可以通过三级缓存机制来解决这种类型的循环依赖。
- Spring默认已经能够解决setter循环依赖,无需额外的配置。Spring会在实例化bean时,通过三级缓存提前暴露bean的引用,从而解决循环依赖。
- 使用
@PostConstruct注解:使用@PostConstruct注解可以在依赖注入完成后执行初始化方法,这样可以在方法内部设置依赖,避免循环依赖。
Spring的三级缓存
Spring通过三级缓存解决了循环依赖的问题。三级缓存分别是singletonObjects、earlySingletonObjects和singletonFactories,分别是三个 Map。
- 一级缓存(singletonObjects):存放最终形态的 Bean(已经实例化、属性填充、初始化),单例池,为“Spring 的单例属性”⽽⽣。一般获取 Bean 都是从这里获取的,但非所有的 Bean 都在单例池里面,例如原型 Bean 就不在里面。
- 二级缓存(earlySingletonObjects):存放过渡 Bean(半成品,尚未属性填充),也就是三级缓存中
ObjectFactory产生的对象,与三级缓存配合使用的,可以防止 AOP 的情况下,每次调用ObjectFactory#getObject()都是会产生新的代理对象的。 - 三级缓存(singletonFactories):存放
ObjectFactory,ObjectFactory的getObject()方法可以生成原始 Bean 对象或者代理对象。三级缓存只会对单例 Bean 生效。
缺点
- 增加了内存开销(需要维护三级缓存,也就是三个 Map),降低了性能(需要进行多次检查和转换)。
- 少部分情况是不支持循环依赖的,比如非单例的 bean 和@Async注解的 bean 无法支持循环依赖。
Spring创建Bean流程
- 先去 一级缓存
singletonObjects中获取,存在就返回; - 如果不存在或者对象正在创建中,于是去 二级缓存
earlySingletonObjects中获取; - 如果还没有获取到,就去 三级缓存
singletonFactories中获取,通过执行ObjectFacotry的getObject()就可以获取该对象,获取成功之后,从三级缓存移除,并将该对象加入到二级缓存中。
Spring 在创建 Bean 的时候,如果允许循环依赖的话,Spring 就会将刚刚实例化完成,但是属性还没有初始化完的 Bean 对象给提前暴露出去。
三级缓存解决循环依赖流程
- 当 Spring 创建 A 之后,发现 A 依赖了 B ,又去创建 B,B 依赖了 A ,又去创建 A;
- 在 B 创建 A 的时候,那么此时 A 就发生了循环依赖,由于 A 此时还没有初始化完成,因此在 一二级缓存 中肯定没有 A;
- 那么此时就去三级缓存中调用 getObject() 方法去获取 A 的 前期暴露的对象 ,也就是调用上边加入的 getEarlyBeanReference() 方法,生成一个 A 的 前期暴露对象;
- 然后就将这个 ObjectFactory 从三级缓存中移除,并且将前期暴露对象放入到二级缓存中,那么 B 就将这个前期暴露对象注入到依赖,来支持循环依赖。
只有两级缓存可以吗
在没有 AOP 的情况下,确实可以只使用一级和三级缓存来解决循环依赖问题。但是,当涉及到 AOP 时,二级缓存就显得非常重要了,因为它确保了即使在 Bean 的创建过程中有多次对早期引用的请求,也始终只返回同一个代理对象,从而避免了同一个 Bean 有多个代理对象的问题。
@Lazy解决循环依赖
@Lazy 用来标识类是否需要懒加载/延迟加载,可以作用在类上、方法上、构造器上、方法参数上、成员变量中。
- 如果一个 Bean 没有被标记为懒加载,那么它会在 Spring IoC 容器启动的过程中被创建和初始化。
- 如果一个 Bean 被标记为懒加载,那么它不会在 Spring IoC 容器启动时立即实例化,而是在第一次被请求时才创建。这可以帮助减少应用启动时的初始化时间,也可以用来解决循环依赖问题。
@Lazy解决循环依赖的原理:
举一个例子,比如说有两个 Bean,A 和 B发生了循环依赖。那么 A 的构造器上添加 @Lazy 注解之后(延迟 Bean B 的实例化),加载的流程如下:
- 创建BeanA实例:Spring开始创建BeanA实例。在创建BeanA实例时,Spring发现其构造函数参数BeanB上有
@Lazy注解。 - 创建BeanB的代理对象:由于
@Lazy注解的存在,Spring不会立即创建BeanB实例,而是创建一个BeanB的 _代理对象_。这个代理对象会延迟实际的BeanB实例化,直到代理对象的某个方法被调用时才创建目标bean。 - 注入代理对象:Spring将BeanB的代理对象注入到BeanA中。
- 完成BeanA的创建:Spring完成BeanA的创建,并继续执行BeanA的初始化方法。
- 创建BeanB实例:当BeanB需要创建时,代理对象会触发实际的BeanB实例化过程。
- 注入BeanA实例:在创建BeanB实例时,Spring会发现BeanB依赖于BeanA,此时BeanA已经创建完成并且在Spring容器中可用,所以可以直接注入BeanA实例。
这里的代理对象使用 AOP 实现,Spring可以创建两种类型的代理对象:
- JDK动态代理:使用Java的反射机制创建代理对象,适用于实现了接口的bean。
- CGLIB代理:使用CGLIB库生成代理对象,适用于没有实现接口的bean。
Spring事务✅
事务是逻辑上的一组操作,要么都执行,要么都不执行。
四大特性:
- 原子性(Atomicity):事务是最小的执行单位,不允许分割。事务的原子性确保动作要么全部完成,要么完全不起作用;
- 一致性(Consistency):执行事务前后,数据保持一致,例如转账业务中,无论事务是否成功,转账者和收款人的总额应该是不变的;
- 隔离性(Isolation):并发访问数据库时,一个用户的事务不被其他事务所干扰,各并发事务之间数据库是独立的;
- 持久性(Durability):一个事务被提交之后。它对数据库中数据的改变是持久的,即使数据库发生故障也不应该对其有任何影响。
Spring对事务的支持
程序是否支持事务首先取决于数据库 ,如使用 MySQL,若 存储引擎是 innodb 引擎,则可以支持事务的,若是 myisam 引擎,那就不支持事务的。
Spring管理事务的两种方式
- 编程式事务:在代码中硬编码(在分布式系统中推荐使用) :通过
TransactionTemplate或者TransactionManager手动管理事务,事务范围过大会出现事务未提交导致超时,因此事务要比锁的粒度更小。 - 声明式事务:在 XML 配置文件中配置或者直接基于注解(单体应用或者简单业务系统推荐使用):实际是通过 AOP 实现(基于@Transactional 的全注解方式使用最多),开发中推荐使用,代码入侵性小。
Spring中的事务管理接口
Spring 框架中,事务管理相关最重要的 3 个接口如下:
PlatformTransactionManager:(平台)事务管理器,Spring 事务策略的核心。Spring通过该接口,为JDBC(DataSourceTransactionManager)、Hibernate(HibernateTransactionManager)、JPA(JpaTransactionManager)等平台提供了对应的事务管理器,但具体由各个平台自己实现。- 主要定义了三个方法:
getTransaction()、commit()、rollback()。// 获得事务
TransactionStatus getTransaction( TransactionDefinition var1) throws TransactionException;
// 提交事务
void commit(TransactionStatus var1) throws TransactionException;
// 回滚事务
void rollback(TransactionStatus var1) throws TransactionException; - 该接口将事务管理行为抽象出来,然后不同的平台去实现它,这样可以保证提供给外部的行为不变,方便扩展。
- 主要定义了三个方法:
TransactionDefinition:事务属性(包含五个方面:事务隔离级别、传播行为、事务超时、是否只读、回滚规则)。TransactionStatus:事务运行状态。- 该接口用来记录事务的状态 定义了一组方法,用来获取或判断事务的相应状态信息。
可以把 PlatformTransactionManager 接口可以被看作是事务上层的管理者,而 TransactionDefinition 和 TransactionStatus 这两个接口可以看作是事务的描述。
PlatformTransactionManager 会根据 TransactionDefinition 的定义比如事务超时时间、隔离级别、传播行为等来进行事务管理 ,而 TransactionStatus 接口则提供了一些方法来获取事务相应的状态比如是否新事务、是否可以回滚等等。
Spring事务传播行为
在 Spring 框架中,事务传播行为(Transaction Propagation Behavior)定义了事务方法如何与现有事务协作。这些传播行为决定了一个事务方法是否在一个现有事务中运行,是否创建一个新的事务,或者是否在没有事务的情况下运行。
Spring事务传播定义了 当一个事务方法调用另一个事务方法时(嵌套事务语义),传播行为决定“子事务如何参与父事务”。
以 父事务(外层) 调 子事务(内层) 为主线:
Spring 提供了七种事务传播行为:
- REQUIRED:如果当前存在事务,则子方法加入该事务;如果当前没有事务,则创建一个新的事务。这是最常用的传播行为。
- 行为:加入当前事务或创建一个新的事务。
- 适用场景:大多数业务场景,确保方法在一个事务中运行。
- REQUIRES_NEW:无论父事务是否存在,都创建一个新的事务,如果存在父事务,则将父事务挂起。
- 行为:始终创建一个新事务,并挂起当前事务(如果存在)。
- 适用场景:审计日志/独立记录失败不影响主事务
- SUPPORTS:如果当前存在事务,则加入该事务;如果当前没有事务,则以非事务方式执行。
- 行为:如果有事务则使用事务,没有则非事务执行。
- 适用场景:既可以在事务中执行也可以在非事务中执行的方法。
- NOT_SUPPORTED:以非事务方式执行操作,如果当前存在事务,则将当前事务挂起。
- 行为:非事务方式执行,如果有事务则挂起当前事务。
- 适用场景:如读操作等不希望事务参与的只读或外部操作
- NEVER:以非事务方式执行,如果当前存在事务,则抛出异常。
- 行为:非事务方式执行,如果有事务则抛出异常。
- 适用场景:确保方法绝对不会在事务中运行的情况。
- MANDATORY:如果当前存在事务,则加入该事务;如果当前没有事务,则抛出异常。
- 行为:必须在事务中执行,如果没有事务则抛出异常。
- 适用场景:必须有现有事务的方法,例如依赖上游事务的操作。
- NESTED:如果当前存在事务,则在嵌套事务内执行;如果当前没有事务,则与
REQUIRED的效果相同。- 行为:如果有事务则创建一个嵌套事务,如果没有则创建一个新事务。
- 适用场景:需要保存部分回滚点的方法,适合复杂的业务场景。
Spring事务隔离级别
TransactionDefinition.ISOLATION_DEFAULT:使用后端数据库默认的隔离级别,MySQL 默认采用的REPEATABLE_READ隔离级别,Oracle 默认采用的READ_COMMITTED隔离级别。TransactionDefinition.ISOLATION_READ_UNCOMMITTED:最低的隔离级别,使用这个隔离级别很少,因为它允许读取尚未提交的数据变更,可能会导致脏读、幻读或不可重复读。TransactionDefinition.ISOLATION_READ_COMMITTED:允许读取并发事务已经提交的数据,可以阻止脏读,但是幻读或不可重复读仍有可能发生。TransactionDefinition.ISOLATION_REPEATABLE_READ:对同一字段的多次读取结果都是一致的,除非数据是被本身事务自己所修改,可以阻止脏读和不可重复读,但幻读仍有可能发生。TransactionDefinition.ISOLATION_SERIALIZABLE:最高的隔离级别,完全服从 ACID 的隔离级别。所有的事务依次逐个执行,这样事务之间就完全不可能产生干扰,也就是说,该级别可以防止脏读、不可重复读以及幻读。但是这将严重影响程序的性能。通常情况下也不会用到该级别。
@Transactional(rollbackFor = Exception.class)注解
Exception 分为运行时异常 RuntimeException 和非运行时异常。事务管理对于企业应用来说是至关重要的,即使出现异常情况,它也可以保证数据的一致性。
当 @Transactional 注解作用于类上时,该类的所有 public 方法将都具有该类型的事务属性,同时也可以在方法级别使用该标注来覆盖类级别的定义。
@Transactional 注解默认回滚策略是只有在遇到RuntimeException(运行时异常) 或者 Error 时才会回滚事务,而不会回滚 Checked Exception(受检查异常)。这是因为 Spring 认为RuntimeException和 Error 是不可预期的错误,而受检异常是可预期的错误,可以通过业务逻辑来处理。
如果想要修改默认的回滚策略,可以使用 @Transactional 注解的 rollbackFor 和 noRollbackFor 属性来指定哪些异常需要回滚,哪些异常不需要回滚。例如,如果想要让所有的异常都回滚事务,可以使用如下的注解:
|
如果想要让某些特定的异常不回滚事务,可以使用如下的注解:
|
Spring事务失效场景
在使用 Spring 框架时,事务管理(Spring Transaction)是一个非常重要的功能,但在某些情况下,事务可能会失效。以下是常见的事务失效场景及其原因分析:
方法未被代理
原因:Spring 的事务管理依赖于 AOP 代理,如果事务方法没有通过代理调用,事务将不会生效。
示例:
|
解决方法:
- 将 methodB() 提取到另一个带有 @Transactional 注解的类中,由代理管理。
- 通过 ApplicationContext 获取当前 Bean 并调用 methodB()。
事务方法为 private 或 final
原因:Spring AOP 基于动态代理,代理类无法拦截 private 或 final 方法。
示例:
|
解决方法:确保事务方法的访问修饰符为 public。
异常未被捕获
原因:Spring 默认只有未捕获的 运行时异常(RuntimeException)或错误(Error)会触发事务回滚。
示例:
|
解决方法:手动抛出异常或配置事务注解,使其支持检查型异常:
嵌套事务传播属性设置错误
原因:默认传播属性为 Propagation.REQUIRED,如果不正确设置传播属性,可能导致事务嵌套失效或不生效。
示例:
|
解决方法:根据实际需求设置正确的传播属性(REQUIRED、REQUIRES_NEW、NESTED 等)。
代理模式不匹配
原因:Spring AOP 默认使用 JDK 动态代理或 CGLIB。如果使用 JDK 动态代理,事务失效可能是由于目标类未实现接口。
解决方法:确保目标类实现接口,或者强制使用 CGLIB 代理:
未启用事务管理
原因:如果没有配置事务管理器或未启用事务支持,事务注解无效。
解决方法:确保在配置类中启用了事务管理:@EnableTransactionManagement
多数据源事务问题
原因:在多数据源环境下,如果没有配置分布式事务或多个数据源事务管理器,事务可能无法正确回滚。
解决方法:使用 @Primary 指定默认事务管理器。 配置分布式事务管理器(如 Atomikos、Seata)。
事务拦截器优先级问题
原因:如果某些切面拦截器优先级高于事务拦截器,可能导致事务未生效。
解决方法:检查 AOP 切面优先级,调整为事务优先级最高。
Spring Data JPA
Spring Data JPA 是 Spring Data 项目的一部分,它为 Java 持久化 API (JPA) 提供了一个高层次的抽象。其主要目的是简化与数据库交互的复杂性,通过最小化配置和编码,使开发者能够更轻松地创建、读取、更新和删除数据库中的数据。
主要特点和功能
- 简化的存储库接口:
- Spring Data JPA 提供了
JpaRepository接口,继承该接口的存储库(Repository)可以自动拥有常见的数据操作方法,如save、findAll、findById、delete等。
- Spring Data JPA 提供了
- 自定义查询方法:
- 通过定义遵循命名规则的方法名,Spring Data JPA 可以自动生成 SQL 查询。例如,
findByLastName方法会生成一个根据lastName字段进行查询的 SQL。
- 通过定义遵循命名规则的方法名,Spring Data JPA 可以自动生成 SQL 查询。例如,
- 查询注解:
- 可以使用
@Query注解编写自定义的 JPQL 或原生 SQL 查询。
- 可以使用
- 分页和排序:
- 支持分页和排序,通过方法参数
Pageable和Sort,可以轻松实现分页和排序功能。
- 支持分页和排序,通过方法参数
- 规格查询:
- 使用
Specification接口,可以创建复杂的动态查询。
- 使用
- 自动实现:
- Spring Data JPA 可以根据接口自动生成实现类,无需手动编写实现代码。
核心组件
- Repository 接口:
CrudRepository:提供基本的 CRUD 操作。PagingAndSortingRepository:在CrudRepository的基础上增加分页和排序功能。JpaRepository:在PagingAndSortingRepository的基础上增加 JPA 相关操作。
- 实体类:
- 使用 JPA 注解(如
@Entity、@Table、@Id等)来映射数据库表和字段。
- 使用 JPA 注解(如
- Spring Data JPA 配置:
- 通过配置文件(如
application.properties或application.yml)来配置数据源、JPA 供应商、数据库方言等。
- 通过配置文件(如
通过这些组件,开发者可以快速创建与数据库交互的应用程序,而不必编写大量的样板代码。Spring Data JPA 的抽象和自动化能力,使得开发过程更加高效和简洁。
JPA审计功能
审计功能主要是帮助记录数据库操作的具体行为比如某条记录是谁创建的、什么时间创建的、最后修改人是谁、最后修改时间是什么时候。
实体之间的关联关系注解
@OneToOne:一对一。@ManyToMany:多对多。@OneToMany:一对多。@ManyToOne:多对一。
利用 @ManyToOne 和 @OneToMany 也可以表达多对多的关联关系。
Spring Security
Spring Security 是一个强大的且高度可定制的认证和访问控制框架,属于 Spring 框架的一部分。它为基于 Spring 的企业应用程序提供了全面的安全性解决方案。以下是 Spring Security 的一些关键特性和功能:
- 认证(Authentication):Spring Security 提供了多种认证方式,包括基于表单的登录、HTTP Basic 认证、OAuth2 认证等。它还支持自定义认证逻辑,可以与数据库、LDAP、OAuth2 提供者等集成。
- 授权(Authorization):授权是指控制用户对资源的访问权限。Spring Security 使用表达式和基于角色的访问控制来实现细粒度的授权控制。你可以通过注解(如
@PreAuthorize、@Secured)或基于 URL 的配置来定义访问规则。 - 安全上下文(Security Context):Spring Security 维护一个安全上下文,其中包含当前用户的认证信息。这个安全上下文可以在应用程序的各个部分访问,用于确定用户的身份和权限。
- 防护机制:Spring Security 提供了多种安全防护机制来防止常见的攻击,如:
- CSRF(跨站请求伪造)防护:通过生成和验证 CSRF 令牌来防止跨站请求伪造攻击。
- 会话固定攻击防护:通过在用户登录后生成新的会话 ID 来防止会话固定攻击。
- **内容安全策略(CSP)**:防止 XSS(跨站脚本攻击)和数据注入攻击。
- 密码存储:Spring Security 提供了多种密码编码器(如 BCrypt、SCrypt、PBKDF2)来安全地存储用户密码。你可以选择合适的密码编码器来加强密码存储的安全性。
- 集成:Spring Security 与其他 Spring 项目(如 Spring Boot、Spring MVC)无缝集成,简化了安全配置和管理。使用 Spring Boot,可以通过自动配置快速启动安全功能。
- 可扩展性:Spring Security 是高度可定制的。你可以扩展或替换其默认实现来满足特定的安全需求。比如,自定义认证提供者、授权管理器、过滤器等。
MyBatis
MyBatis 是一个流行的持久层框架,用于简化 Java 应用程序与数据库之间的交互。主要提供下面功能:
- SQL 映射:MyBatis 允许你使用 XML 或注解的方式将 SQL 语句映射到 Java 方法上,这样可以直接在代码中调用这些方法来执行 SQL 查询和更新操作。
- 简化 JDBC 操作:MyBatis 封装了 JDBC 操作,使开发者不需要处理复杂的 JDBC API,如手动管理连接、结果集处理等。
- 动态 SQL:MyBatis 支持动态生成 SQL 语句,可以根据条件灵活构建查询或更新语句,避免了在代码中拼接 SQL 字符串的麻烦。
- 缓存支持:MyBatis 提供了一级缓存(默认开启)和二级缓存(可选配置),通过缓存机制提高了数据库查询的性能。
- 灵活的配置:MyBatis 提供了多种配置方式,可以通过 XML 文件、注解和 Java 配置类进行配置,满足不同的使用需求。
- 扩展性:MyBatis 具有良好的扩展性,开发者可以通过插件机制自定义和扩展 MyBatis 的功能,如自定义类型处理器、插件等。
#{} 和 ${} 的区别是什么?
${}是 Properties 文件中的变量占位符,它可以用于标签属性值和 sql 内部,属于原样文本替换,可以替换任意内容,比如${driver}会被原样替换为com.mysql.jdbc. Driver。
一个示例:根据参数按任意字段排序:
select * from users order by ${orderCols} |
orderCols可以是 name、name desc、name,sex asc等,实现灵活的排序。
#{}是 sql 的参数占位符,MyBatis 会将 sql 中的#{}替换为? 号,在 sql 执行前会使用 PreparedStatement 的参数设置方法,按序给 sql 的? 号占位符设置参数值,比如 ps.setInt(0, parameterValue),#{item.name} 的取值方式为使用反射从参数对象中获取 item 对象的 name 属性值,相当于 param.getItem().getName()。
xml 映射文件中,除了常见的 select、insert、update、delete 标签之外,还有哪些标签?
注:这道题是京东面试官面试我时问的。
答:还有很多其他的标签, <resultMap>、 <parameterMap>、 <sql>、 <include>、 <selectKey> ,加上动态 sql 的 9 个标签, trim|where|set|foreach|if|choose|when|otherwise|bind 等,其中 <sql> 为 sql 片段标签,通过 <include> 标签引入 sql 片段, <selectKey> 为不支持自增的主键生成策略标签。
Dao 接口的工作原理是什么?Dao 接口里的方法,参数不同时,方法能重载吗?
注:这道题也是京东面试官面试我被问的。
答:最佳实践中,通常一个 xml 映射文件,都会写一个 Dao 接口与之对应。Dao 接口就是人们常说的 Mapper 接口,接口的全限名,就是映射文件中的 namespace 的值,接口的方法名,就是映射文件中 MappedStatement 的 id 值,接口方法内的参数,就是传递给 sql 的参数。 Mapper 接口是没有实现类的,当调用接口方法时,接口全限名+方法名拼接字符串作为 key 值,可唯一定位一个 MappedStatement ,举例:com.mybatis3.mappers. StudentDao.findStudentById ,可以唯一找到 namespace 为 com.mybatis3.mappers. StudentDao 下面 id = findStudentById 的 MappedStatement 。在 MyBatis 中,每一个 <select>、 <insert>、 <update>、 <delete> 标签,都会被解析为一个 MappedStatement 对象。
Dao 接口里的方法,是不能重载的,因为是全限名+方法名的保存和寻找策略。
Dao 接口里的方法可以重载,但是 Mybatis 的 xml 里面的 ID 不允许重复。
Mybatis 版本 3.3.0,亲测如下:
/** |
然后在 StuMapper.xml 中利用 Mybatis 的动态 sql 就可以实现。
<select id="getAllStu" resultType="com.pojo.Student"> |
能正常运行,并能得到相应的结果,这样就实现了在 Dao 接口中写重载方法。
Mybatis 的 Dao 接口可以有多个重载方法,但是多个接口对应的映射必须只有一个,否则启动会报错。
相关 issue:更正:Dao 接口里的方法可以重载,但是 Mybatis 的 xml 里面的 ID 不允许重复!。
Dao 接口的工作原理是 JDK 动态代理,MyBatis 运行时会使用 JDK 动态代理为 Dao 接口生成代理 proxy 对象,代理对象 proxy 会拦截接口方法,转而执行 MappedStatement 所代表的 sql,然后将 sql 执行结果返回。
补充:
Dao 接口方法可以重载,但是需要满足以下条件:
- 仅有一个无参方法和一个有参方法
- 多个有参方法时,参数数量必须一致。且使用相同的
@Param,或者使用param1这种
测试如下:
PersonDao.java
Person queryById(); |
PersonMapper.xml
<select id="queryById" resultMap="PersonMap"> |
org.apache.ibatis.scripting.xmltags. DynamicContext. ContextAccessor#getProperty 方法用于获取 <if> 标签中的条件值
public Object getProperty(Map context, Object target, Object name) { |
parameterObject 为 map,存放的是 Dao 接口中参数相关信息。
((Map)parameterObject).get(name) 方法如下
public V get(Object key) { |
queryById()方法执行时,parameterObject为 null,getProperty方法返回 null 值,<if>标签获取的所有条件值都为 null,所有条件不成立,动态 sql 可以正常执行。queryById(1L)方法执行时,parameterObject为 map,包含了id和param1两个 key 值。当获取<if>标签中name的属性值时,进入((Map)parameterObject).get(name)方法中,map 中 key 不包含name,所以抛出异常。queryById(1L,"1")方法执行时,parameterObject中包含id,param1,name,param2四个 key 值,id和name属性都可以获取到,动态 sql 正常执行。
MyBatis 是如何进行分页的?分页插件的原理是什么?
注:我出的。
答:**(1)** MyBatis 使用 RowBounds 对象进行分页,它是针对 ResultSet 结果集执行的内存分页,而非物理分页;**(2)** 可以在 sql 内直接书写带有物理分页的参数来完成物理分页功能,**(3)** 也可以使用分页插件来完成物理分页。
分页插件的基本原理是使用 MyBatis 提供的插件接口,实现自定义插件,在插件的拦截方法内拦截待执行的 sql,然后重写 sql,根据 dialect 方言,添加对应的物理分页语句和物理分页参数。
举例:select _ from student ,拦截 sql 后重写为:select t._ from (select \* from student)t limit 0,10
简述 MyBatis 的插件运行原理,以及如何编写一个插件
注:我出的。
答:MyBatis 仅可以编写针对 ParameterHandler、 ResultSetHandler、 StatementHandler、 Executor 这 4 种接口的插件,MyBatis 使用 JDK 的动态代理,为需要拦截的接口生成代理对象以实现接口方法拦截功能,每当执行这 4 种接口对象的方法时,就会进入拦截方法,具体就是 InvocationHandler 的 invoke() 方法,当然,只会拦截那些你指定需要拦截的方法。
实现 MyBatis 的 Interceptor 接口并复写 intercept() 方法,然后在给插件编写注解,指定要拦截哪一个接口的哪些方法即可,记住,别忘了在配置文件中配置你编写的插件。
MyBatis 执行批量插入,能返回数据库主键列表吗?
注:我出的。
答:能,JDBC 都能,MyBatis 当然也能。
MyBatis 动态 sql 是做什么的?都有哪些动态 sql?能简述一下动态 sql 的执行原理不?
注:我出的。
答:MyBatis 动态 sql 可以让我们在 xml 映射文件内,以标签的形式编写动态 sql,完成逻辑判断和动态拼接 sql 的功能。其执行原理为,使用 OGNL 从 sql 参数对象中计算表达式的值,根据表达式的值动态拼接 sql,以此来完成动态 sql 的功能。
MyBatis 提供了 9 种动态 sql 标签:
<if></if><where></where>(trim,set)<choose></choose>(when, otherwise)<foreach></foreach><bind/>
关于 MyBatis 动态 SQL 的详细介绍,请看这篇文章:Mybatis 系列全解(八):Mybatis 的 9 大动态 SQL 标签你知道几个? 。
关于这些动态 SQL 的具体使用方法,请看这篇文章:Mybatis【13】– Mybatis 动态 sql 标签怎么使用?
MyBatis 是如何将 sql 执行结果封装为目标对象并返回的?都有哪些映射形式?
注:我出的。
答:第一种是使用 <resultMap> 标签,逐一定义列名和对象属性名之间的映射关系。第二种是使用 sql 列的别名功能,将列别名书写为对象属性名,比如 T_NAME AS NAME,对象属性名一般是 name,小写,但是列名不区分大小写,MyBatis 会忽略列名大小写,智能找到与之对应对象属性名,你甚至可以写成 T_NAME AS NaMe,MyBatis 一样可以正常工作。
有了列名与属性名的映射关系后,MyBatis 通过反射创建对象,同时使用反射给对象的属性逐一赋值并返回,那些找不到映射关系的属性,是无法完成赋值的。
MyBatis 能执行一对一、一对多的关联查询吗?都有哪些实现方式,以及它们之间的区别
注:我出的。
答:能,MyBatis 不仅可以执行一对一、一对多的关联查询,还可以执行多对一,多对多的关联查询,多对一查询,其实就是一对一查询,只需要把 selectOne() 修改为 selectList() 即可;多对多查询,其实就是一对多查询,只需要把 selectOne() 修改为 selectList() 即可。
关联对象查询,有两种实现方式,一种是单独发送一个 sql 去查询关联对象,赋给主对象,然后返回主对象。另一种是使用嵌套查询,嵌套查询的含义为使用 join 查询,一部分列是 A 对象的属性值,另外一部分列是关联对象 B 的属性值,好处是只发一个 sql 查询,就可以把主对象和其关联对象查出来。
那么问题来了,join 查询出来 100 条记录,如何确定主对象是 5 个,而不是 100 个?其去重复的原理是 <resultMap> 标签内的 <id> 子标签,指定了唯一确定一条记录的 id 列,MyBatis 根据 <id> 列值来完成 100 条记录的去重复功能, <id> 可以有多个,代表了联合主键的语意。
同样主对象的关联对象,也是根据这个原理去重复的,尽管一般情况下,只有主对象会有重复记录,关联对象一般不会重复。
举例:下面 join 查询出来 6 条记录,一、二列是 Teacher 对象列,第三列为 Student 对象列,MyBatis 去重复处理后,结果为 1 个老师 6 个学生,而不是 6 个老师 6 个学生。
| t_id | t_name | s_id |
|---|---|---|
| 1 | teacher | 38 |
| 1 | teacher | 39 |
| 1 | teacher | 40 |
| 1 | teacher | 41 |
| 1 | teacher | 42 |
| 1 | teacher | 43 |
MyBatis 是否支持延迟加载?如果支持,它的实现原理是什么?
注:我出的。
答:MyBatis 仅支持 association 关联对象和 collection 关联集合对象的延迟加载,association 指的就是一对一,collection 指的就是一对多查询。在 MyBatis 配置文件中,可以配置是否启用延迟加载 lazyLoadingEnabled=true|false。
它的原理是,使用 CGLIB 创建目标对象的代理对象,当调用目标方法时,进入拦截器方法,比如调用 a.getB().getName() ,拦截器 invoke() 方法发现 a.getB() 是 null 值,那么就会单独发送事先保存好的查询关联 B 对象的 sql,把 B 查询上来,然后调用 a.setB(b),于是 a 的对象 b 属性就有值了,接着完成 a.getB().getName() 方法的调用。这就是延迟加载的基本原理。
当然了,不光是 MyBatis,几乎所有的包括 Hibernate,支持延迟加载的原理都是一样的。
MyBatis 的 xml 映射文件中,不同的 xml 映射文件,id 是否可以重复?
注:我出的。
答:不同的 xml 映射文件,如果配置了 namespace,那么 id 可以重复;如果没有配置 namespace,那么 id 不能重复;毕竟 namespace 不是必须的,只是最佳实践而已。
原因就是 namespace+id 是作为 Map<String, MappedStatement> 的 key 使用的,如果没有 namespace,就剩下 id,那么,id 重复会导致数据互相覆盖。有了 namespace,自然 id 就可以重复,namespace 不同,namespace+id 自然也就不同。
MyBatis 中如何执行批处理?
注:我出的。
答:使用 BatchExecutor 完成批处理。
MyBatis 都有哪些 Executor 执行器?它们之间的区别是什么?
注:我出的
答:MyBatis 有三种基本的 Executor 执行器:
SimpleExecutor: 每执行一次 update 或 select,就开启一个 Statement 对象,用完立刻关闭 Statement 对象。ReuseExecutor: 执行 update 或 select,以 sql 作为 key 查找 Statement 对象,存在就使用,不存在就创建,用完后,不关闭 Statement 对象,而是放置于 Map<String, Statement>内,供下一次使用。简言之,就是重复使用 Statement 对象。- **
BatchExecutor**:执行 update(没有 select,JDBC 批处理不支持 select),将所有 sql 都添加到批处理中(addBatch()),等待统一执行(executeBatch()),它缓存了多个 Statement 对象,每个 Statement 对象都是 addBatch()完毕后,等待逐一执行 executeBatch()批处理。与 JDBC 批处理相同。
作用范围:Executor 的这些特点,都严格限制在 SqlSession 生命周期范围内。
MyBatis 中如何指定使用哪一种 Executor 执行器?
注:我出的
答:在 MyBatis 配置文件中,可以指定默认的 ExecutorType 执行器类型,也可以手动给 DefaultSqlSessionFactory 的创建 SqlSession 的方法传递 ExecutorType 类型参数。
MyBatis 是否可以映射 Enum 枚举类?
注:我出的
答:MyBatis 可以映射枚举类,不单可以映射枚举类,MyBatis 可以映射任何对象到表的一列上。映射方式为自定义一个 TypeHandler ,实现 TypeHandler 的 setParameter() 和 getResult() 接口方法。 TypeHandler 有两个作用:
- 一是完成从 javaType 至 jdbcType 的转换;
- 二是完成 jdbcType 至 javaType 的转换,体现为
setParameter()和getResult()两个方法,分别代表设置 sql 问号占位符参数和获取列查询结果。
MyBatis 映射文件中,如果 A 标签通过 include 引用了 B 标签的内容,请问,B 标签能否定义在 A 标签的后面,还是说必须定义在 A 标签的前面?
注:我出的
答:虽然 MyBatis 解析 xml 映射文件是按照顺序解析的,但是,被引用的 B 标签依然可以定义在任何地方,MyBatis 都可以正确识别。
原理是,MyBatis 解析 A 标签,发现 A 标签引用了 B 标签,但是 B 标签尚未解析到,尚不存在,此时,MyBatis 会将 A 标签标记为未解析状态,然后继续解析余下的标签,包含 B 标签,待所有标签解析完毕,MyBatis 会重新解析那些被标记为未解析的标签,此时再解析 A 标签时,B 标签已经存在,A 标签也就可以正常解析完成了。
简述 MyBatis 的 xml 映射文件和 MyBatis 内部数据结构之间的映射关系?
注:我出的
答:MyBatis 将所有 xml 配置信息都封装到 All-In-One 重量级对象 Configuration 内部。在 xml 映射文件中, <parameterMap> 标签会被解析为 ParameterMap 对象,其每个子元素会被解析为 ParameterMapping 对象。 <resultMap> 标签会被解析为 ResultMap 对象,其每个子元素会被解析为 ResultMapping 对象。每一个 <select>、<insert>、<update>、<delete> 标签均会被解析为 MappedStatement 对象,标签内的 sql 会被解析为 BoundSql 对象。
为什么说 MyBatis 是半自动 ORM 映射工具?它与全自动的区别在哪里?
注:我出的
答:Hibernate 属于全自动 ORM 映射工具,使用 Hibernate 查询关联对象或者关联集合对象时,可以根据对象关系模型直接获取,所以它是全自动的。而 MyBatis 在查询关联对象或关联集合对象时,需要手动编写 sql 来完成,所以,称之为半自动 ORM 映射工具。
面试题看似都很简单,但是想要能正确回答上来,必定是研究过源码且深入的人,而不是仅会使用的人或者用的很熟的人,以上所有面试题及其答案所涉及的内容,在我的 MyBatis 系列博客中都有详细讲解和原理分析。
文章推荐
- 2W 字全面剖析 Mybatis 中的 9 种设计模式
- 从零开始实现一个 MyBatis 加解密插件
- MyBatis 最全使用指南
- 脑洞打开!第一次看到这样使用 MyBatis 的,看得我一愣一愣的。
- MyBatis 居然也有并发问题
SpringBoot
SpringBoot注解
Spring Boot 注解是用来简化配置和开发的核心部分,通过注解可以方便地配置应用程序,处理依赖注入,定义控制器,管理数据库实体等。以下是一些常用的 Spring Boot 注解及其功能:
1. @SpringBootApplication
是一个复合注解,包含了
@Configuration,@EnableAutoConfiguration和@ComponentScan三个注解。用来标记一个主程序类,表示这是一个 Spring Boot 应用的入口。
public class MyApplication {
public static void main(String[] args) {
SpringApplication.run(MyApplication.class, args);
}
}
2. @Configuration
用于标记一个类作为 Spring IoC 容器的配置类,替代传统的 XML 配置文件。
public class MyConfig {
public MyService myService() {
return new MyServiceImpl();
}
}
3. @Bean
用于定义 Spring IoC 容器管理的 Bean,通常与
@Configuration一起使用。
public DataSource dataSource() {
return new HikariDataSource();
}
4. @ComponentScan
用于指定要扫描的包及其组件。Spring Boot 自动扫描
@Component,@Service,@Repository,@Controller等注解的类。
public class MyApp {}
5. @EnableAutoConfiguration
- 告诉 Spring Boot 根据添加的依赖来自动配置 Spring 应用程序。
6. @RestController
是
@Controller和@ResponseBody的组合,通常用于 RESTful Web 服务。表示该类中的每个方法都会返回一个 JSON 或 XML 响应,而不是视图。
public class MyController {
public String hello() {
return "Hello, World!";
}
}
7. @RequestMapping
用于映射 HTTP 请求到处理方法上,支持 GET, POST, PUT, DELETE 等。
public class ApiController {
public List<User> getUsers() {
return userService.getAllUsers();
}
}
8. @GetMapping, @PostMapping, @PutMapping, @DeleteMapping
- 这些注解是
@RequestMapping的简化版本,用于分别处理 GET、POST、PUT 和 DELETE 请求。
9. @Autowired
用于自动注入依赖,Spring 会自动找到并注入该类型的 Bean。
public class MyService {
private UserRepository userRepository;
}
10. @Service
- 标记业务逻辑类,Spring 会自动将其注册为 Bean,并可用于自动注入。
11. @Repository
- 标记数据访问类(DAO 层),Spring 会自动处理异常的转换。
12. @Controller
- 标记为控制器类,处理请求并返回视图。
13. @PathVariable
用于获取 URL 中的动态路径参数。
public User getUser( Long id) {
return userService.findById(id);
}
14. @RequestParam
用于获取请求参数中的值。
public List<User> searchUsers( String name) {
return userService.searchByName(name);
}
15. @RequestBody
用于将请求体中的 JSON 自动转换为 Java 对象。
public User createUser( User user) {
return userService.save(user);
}
16. @Transactional
用于标记方法或类的事务性操作,确保方法内的操作要么全部成功,要么全部回滚。
public void transferMoney(Long fromAccountId, Long toAccountId, Double amount) {
// 业务逻辑
}
这些注解大大简化了 Spring Boot 的配置和开发过程,使开发者能够快速构建健壮的 Web 应用。
SpringBoot启动流程
- 调用启动类的
main方法- Spring Boot 应用通常是通过一个包含
@SpringBootApplication注解的主类启动的,该类的main方法中调用SpringApplication.run()。
- Spring Boot 应用通常是通过一个包含
- 创建
SpringApplication实例SpringApplication.run()内部首先会创建一个SpringApplication实例,主要用于配置和管理整个应用的启动过程。- 这个实例初始化了一些基本的属性,比如:启动参数、运行环境(如开发、生产)、应用类型(如 Web 应用或非 Web 应用)。
- 设置启动配置
- Spring Boot 会根据应用的上下文和依赖来设置配置属性,例如:
- 通过
ApplicationContextInitializer实例对上下文进行初始化。 - 加载所有在
META-INF/spring.factories文件中声明的ApplicationListener监听器。
- 通过
- 此时,
SpringApplication根据类路径、系统属性等配置自动决定应用类型(Reactive、Servlet或None)。
- Spring Boot 会根据应用的上下文和依赖来设置配置属性,例如:
- 启动引导器(
SpringApplicationRunListeners):Spring Boot 创建并启动SpringApplicationRunListeners,它们会监听应用启动的各个阶段,并触发相应事件。主要包括以下几个事件:- Starting:表示应用程序刚刚启动。
- Environment Prepared:此阶段设置环境参数(例如配置文件、属性源等)。
- Context Prepared:在创建并配置好
ApplicationContext后触发。 - Context Loaded:当所有 Bean 定义被加载到上下文但尚未被实例化时触发。
- Started:表示
ApplicationContext已经启动并准备接受请求。
- 创建并准备
ApplicationContext- Spring Boot 根据应用的类型(比如 Web 应用)创建适当的
ApplicationContext,例如:- Web 应用使用
AnnotationConfigServletWebServerApplicationContext。 - 非 Web 应用使用
AnnotationConfigApplicationContext。
- Web 应用使用
- 然后,Spring Boot 开始加载
@Configuration类、扫描组件并注册所有的 Bean 定义。
- Spring Boot 根据应用的类型(比如 Web 应用)创建适当的
- 配置环境 (
Environment)- 在
ApplicationContext准备好后,Spring Boot 开始配置运行时环境。 - 环境配置包含了系统属性、环境变量以及外部配置文件(如
application.properties或application.yml),并通过ConfigurableEnvironment注入到上下文中。
- 在
- 刷新
ApplicationContext- Spring Boot 调用
refresh()方法,完成ApplicationContext的初始化,包括 Bean 的创建、依赖注入、生命周期管理等。 - 在此阶段,所有的 Bean 被完全加载和实例化,
CommandLineRunner和ApplicationRunner也会在此之后执行。
- Spring Boot 调用
- 启动内嵌的 Web 服务器(如果有)
- 如果是 Web 应用,Spring Boot 会在应用上下文加载完成后启动内嵌的 Web 服务器(例如 Tomcat、Jetty 或 Undertow)。
- 这个步骤通常是通过
WebServerStartStopLifecycle组件来完成的。
ApplicationRunner和CommandLineRunner执行- 一旦所有的 Bean 都初始化完毕,Spring Boot 会执行所有实现了
ApplicationRunner或CommandLineRunner接口的组件。这些组件通常用于执行一些应用启动后的初始化逻辑。
- 一旦所有的 Bean 都初始化完毕,Spring Boot 会执行所有实现了
- 完成启动,进入事件循环
- 启动流程最后,Spring Boot 进入应用的主事件循环(对于 Web 应用来说)。此时应用已经可以接收 HTTP 请求或执行其他业务逻辑。
Tomcat如何接收http请求
- 启动和初始化
- 启动 Tomcat
- 当 Tomcat 启动时,它会加载并初始化所有配置文件(如
server.xml、web.xml)。 - 它会创建并配置一个或多个 Connector 对象,这些对象负责接收来自客户端的 HTTP 请求。
- 当 Tomcat 启动时,它会加载并初始化所有配置文件(如
- 配置 Connector
- 在
server.xml文件中配置 Connector,例如:<Connector port="8080" protocol="HTTP/1.1"
connectionTimeout="20000"
redirectPort="8443" /> - Connector 会监听指定的端口(例如 8080),并处理进入的请求。
- 在
- 启动 Tomcat
- 接收 HTTP 请求
- 监听端口:Connector 监听配置的端口,接收来自客户端的 TCP 连接。
- 建立连接:当有客户端发起连接时,Connector 接受这个连接,并将其交给一个处理线程。
- 请求处理
- 请求解析:处理线程会解析 HTTP 请求数据,包括请求行(请求方法、请求 URI 和协议)、请求头和请求体。请求数据会被封装成一个
HttpServletRequest对象。 - 请求路由:Tomcat 会根据请求的 URI 进行路由,将请求分发到相应的
Servlet。 - 调用 Servlet:请求会被传递到适当的
Servlet实例的service()方法中。具体的处理由doGet()、doPost()等方法实现,取决于请求的方法类型。 - 生成响应:
Servlet处理完请求后,会生成响应内容并将其封装到HttpServletResponse对象中。响应内容包括响应状态码、响应头和响应体。 - 发送响应:处理线程将
HttpServletResponse对象中的响应数据写回到客户端。Tomcat 会将响应数据通过网络发送回客户端,并关闭连接(如果是非持久连接)。
- 请求解析:处理线程会解析 HTTP 请求数据,包括请求行(请求方法、请求 URI 和协议)、请求头和请求体。请求数据会被封装成一个
- 关闭连接:根据请求的
Connection头部的值(如Connection: keep-alive),Tomcat 决定是否保持连接以处理后续请求。在处理完请求后,Tomcat 可能会关闭连接或重用以提高性能。
SpringBoot自动装配原理✅
自动装配(Auto-Configuration)是 Spring Boot 的核心能力。它会根据项目中的依赖、容器中已有的 Bean 和配置文件中的属性,判断应用需要哪些组件,并自动将它们注册到 Spring 容器中。例如引入 Web Starter 后,Spring Boot 就可以自动配置 Spring MVC 和内嵌 Tomcat,不再需要开发者手动编写大量配置。
Spring Boot 自动装配的整体流程如下:
- 启动自动装配
- 启动类上的
@SpringBootApplication是一个组合注解,主要包含配置@SpringBootConfiguration、启动自动配置@EnableAutoConfiguration和组件扫描@ComponentScan。 @ComponentScan负责扫描业务代码中的@Component、@Service、@Controller等组件;@EnableAutoConfiguration负责导入框架提供的自动配置类。两者职责不同,不要混为一谈。
- 启动类上的
- 导入自动配置选择器
@EnableAutoConfiguration通过@Import(AutoConfigurationImportSelector.class)引入AutoConfigurationImportSelector。AutoConfigurationImportSelector会收集自动配置候选类,并完成去重、排除和初步过滤。此时加载的是“候选配置”,并不代表它们都会生效。
- 加载自动配置候选类
- Spring Boot 2.6 及以前通过
SpringFactoriesLoader读取META-INF/spring.factories中EnableAutoConfiguration对应的自动配置类。 - Spring Boot 2.7 引入并推荐使用
META-INF/spring/org.springframework.boot.autoconfigure.AutoConfiguration.imports,由ImportCandidates读取其中的自动配置类,同时兼容旧的spring.factories方式。 - Spring Boot 3.x 不再支持通过
spring.factories的EnableAutoConfiguration键注册自动配置,必须使用AutoConfiguration.imports。需要注意,spring.factories的其他用途并没有全部被移除。
- Spring Boot 2.6 及以前通过
- 根据条件过滤配置
- 自动配置类通常会使用一系列
@Conditional条件注解,只有满足条件时才会生效。 @ConditionalOnClass:类路径中存在指定类时生效。例如存在DataSource类,才考虑配置数据源。@ConditionalOnBean:容器中存在指定 Bean 时生效。@ConditionalOnMissingBean:容器中不存在指定 Bean 时生效,常用于让 Spring Boot 的默认配置给用户自定义配置让路。@ConditionalOnProperty:配置文件中的属性满足要求时生效。@ConditionalOnWebApplication:当前应用是指定类型的 Web 应用时生效。
- 自动配置类通常会使用一系列
- 注册 Bean 并绑定配置
- 条件满足后,自动配置类会作为配置类参与容器刷新,其中通过
@Bean定义的组件会被注册到 IoC 容器。 @EnableConfigurationProperties配合@ConfigurationProperties,可以把application.properties或application.yml中的配置绑定到属性对象,再用于创建 Bean。
- 条件满足后,自动配置类会作为配置类参与容器刷新,其中通过
- 用户配置优先
- Spring Boot 的自动配置通常带有
@ConditionalOnMissingBean。如果用户已经定义了同类型 Bean,默认配置就不会再创建,这也是“约定优于配置”的体现。 - 用户还可以通过配置文件覆盖默认属性,或者使用
@SpringBootApplication(exclude = ...)、spring.autoconfigure.exclude排除指定的自动配置类。
- Spring Boot 的自动配置通常带有
- 完成容器初始化
- 当
SpringApplication.run()推进到刷新ApplicationContext时,筛选后的自动配置类会和普通配置类一起完成 Bean 定义注册、实例化和依赖注入。 - 如果需要排查某个自动配置为什么生效或没有生效,可以使用
--debug或设置debug=true查看条件评估报告(Condition Evaluation Report)。
- 当
一言以蔽之,Spring Boot 自动装配就是:@EnableAutoConfiguration 导入候选配置类,条件注解决定配置是否生效,满足条件后注册 Bean,并在用户已经自定义 Bean 时主动让路。
如何自定义一个Spring Boot Starter✅
Starter 的作用是让业务项目引入一个依赖,就能获得相关依赖和默认配置,让代码快速跨应用复用。
自定义 Starter 的核心可以分成两部分:Starter 模块负责聚合依赖,AutoConfiguration 模块负责根据条件自动创建 Bean。下面以一个问候服务 greeting-spring-boot-starter 为例。
设计模块结构
- 标准做法通常拆成
greeting-spring-boot-starter和greeting-spring-boot-starter-autoconfigure两个模块。 starter模块只负责聚合依赖;autoconfigure模块存放业务组件、配置属性和自动配置类。- 如果只是公司内部使用的小组件,也可以把两部分合并成一个模块,不必为了形式强行拆分。
- 标准做法通常拆成
定义配置属性和业务组件
- 使用
@ConfigurationProperties接收业务项目中的配置,再把配置传给真正提供能力的组件。
public class GreetingProperties {
private String prefix = "Hello";
public String getPrefix() { return prefix; }
public void setPrefix(String prefix) { this.prefix = prefix; }
}
public class GreetingService {
private final String prefix;
public GreetingService(String prefix) { this.prefix = prefix; }
public String greet(String name) { return prefix + ", " + name; }
}- 使用
编写自动配置类
- 使用
@AutoConfiguration声明自动配置类,使用@EnableConfigurationProperties注册配置属性。 @ConditionalOnProperty控制功能开关,@ConditionalOnMissingBean保证用户自己提供 Bean 时,默认实现会主动让路。
public class GreetingAutoConfiguration {
GreetingService greetingService(GreetingProperties properties) {
return new GreetingService(properties.getPrefix());
}
}- 使用
注册自动配置类
- Spring Boot 2.6 及以前主要使用
META-INF/spring.factories:
META-INF/spring.factories
org.springframework.boot.autoconfigure.EnableAutoConfiguration=\
com.example.greeting.GreetingAutoConfiguration- 这时自动配置类通常使用
@Configuration(proxyBeanMethods = false),因为@AutoConfiguration是 Spring Boot 2.7 才引入的。 - Spring Boot 2.7 同时支持
spring.factories和新的AutoConfiguration.imports,推荐逐步迁移到新方式。 - Spring Boot 3.x 不再支持通过
spring.factories的EnableAutoConfiguration键注册自动配置,必须创建:
META-INF/spring/org.springframework.boot.autoconfigure.AutoConfiguration.imports
- 文件内容是自动配置类的全限定名,每行一个:
com.example.greeting.GreetingAutoConfiguration
- Spring Boot 2.6 及以前主要使用
聚合 Starter 依赖
starter模块依赖autoconfigure模块和使用方真正需要的第三方库,本身通常不写业务代码。autoconfigure模块至少需要依赖spring-boot-autoconfigure。spring-boot-configuration-processor只用于生成 IDE 配置提示,不是自动装配生效的必要条件。
引入并验证 Starter
- 业务项目先通过 Maven 引入
greeting-spring-boot-starter:
<dependency>
    <groupId>com.example</groupId>
    <artifactId>greeting-spring-boot-starter</artifactId>
    <version>1.0.0</version>
</dependency>- 引入后自动配置默认生效,可以直接注入
GreetingService。如果需要修改默认前缀或关闭功能,再添加配置:
demo:
  greeting:
    enabled: true
prefix: Hi- 测试时至少验证三种情况:默认配置能够创建 Bean;
enabled=false时不创建 Bean;用户自定义GreetingService后,默认 Bean 会让路。
- 业务项目先通过 Maven 引入
一言以蔽之,自定义 Starter 就是:定义配置和业务组件,编写带条件的自动配置类,在 AutoConfiguration.imports 中完成注册,最后用 Starter 模块把依赖聚合起来。
自定义Starter的目的
在多个 Java 应用共享同一业务域公共能力的场景中,自定义 Starter 主要解决四个组织级问题:
- 跨应用复用
- 审计日志、日志脱敏等能力会被多个应用重复使用。没有 Starter 时只能复制代码;有了 Starter,应用引入一个依赖坐标即可接入。
- 例如审计自动配置类可以把拦截器注册到持久层相关组件中,业务应用不需要重复编写接入代码。
- 统一技术标准
- 同一业务域的安全规范、异常体系和校验规则需要保持一致。Starter 可以把规范固化成代码,从“文档要求大家遵守”变成“引入后默认生效”。
- 分离业务与基础设施
- 业务应用只关注订单、结算等核心业务,审计、脱敏、审批等横切能力下沉到 Starter,由基础能力团队统一维护。
- 集中演进
- 安全漏洞修复或公共能力升级时,只需修改 Starter 并推动应用升级版本,不需要在每个应用中重复修改。
- 同时配合
@ConditionalOnMissingBean保留扩展点,个别应用需要定制时可以覆盖默认实现,不必 fork 整套代码。
为什么一个项目中会有多个Starter
技术上当然可以把所有能力塞进一个 Starter,但会立刻付出四笔代价:
依赖绑架
- Starter 会把声明的依赖传递给使用方。例如审计 Starter 可能继续传递持久层、任务调度和基础工具等依赖。
- 如果所有能力都放进一个 Starter,应用哪怕只想使用一个工具类,也可能被迫引入大数据 SDK、流程客户端、缓存客户端等大量无关依赖。
- 最终会导致构建产物膨胀、自动配置评估增多、依赖冲突概率上升,安全审计面也随之扩大。
发布节奏互相锁死
- 如果所有能力共用一个制品,修改一行审计代码也要发布整个 Starter,所有使用方都需要重新升级和回归。
- 拆分后,升级审计 Starter 只影响真正依赖它的应用,其他应用不需要被迫跟随。
故障半径扩大
- 大 Starter 中任意一个能力出现启动期 Bug,都可能阻塞所有应用启动,即使这些应用根本没有使用该能力。
- 按能力域拆分后,问题会被限制在引用了对应 Starter 的应用中。
无法按需组合
- 每个 Starter 对应一个横切能力域,使用方可以像搭积木一样组合:
核心业务应用 = 基础工具 + 安全 + 审计 + 流程 + 数据集成
管理后台应用 = 基础工具 + 安全
其他业务应用 = 根据需要选择能力- Starter 之间也可以分层依赖,例如审计 Starter 依赖任务调度 Starter 和基础工具 Starter。如果合成一个大 Starter,就失去了这种组合弹性。
一句话概括,一个大 Starter 也能把功能做出来,但多个 Starter 才能做到“用多少拿多少、改谁发谁、坏哪隔哪”。
SpringBoot如何配置跨域
在Spring Boot中实现跨域操作,主要是通过配置CORS(跨源资源共享)来实现的。CORS是一个W3C标准,它允许你指定哪些动态资源允许跨域访问。Spring Boot通过提供@CrossOrigin注解和全局CORS配置两种方式来实现跨域请求的支持。
使用@CrossOrigin注解
@CrossOrigin注解可以添加到控制器(Controller)类上或特定的方法上,以允许跨域请求。这个注解可以指定允许的源(origins)、HTTP方法、头部(headers)等。全局CORS配置
如果应用中有多个控制器或方法需要跨域访问,那么使用全局CORS配置会更加方便。Spring Boot允许你通过添加一个配置类并实现WebMvcConfigurer接口来自定义CORS策略。
|
SpringClod
SpringBoot/SpringCloud区别
Spring Boot和Spring Cloud是Spring生态系统中两个不同但经常一起使用的框架,它们在职责和应用场景上有所区别:
1. Spring Boot:
- 定义:Spring Boot是一个快速构建单个独立应用的框架,简化了Spring应用的开发过程。
- 功能:通过自动配置、内嵌服务器(如Tomcat)、无XML配置、应用监控等特性,使开发人员可以快速构建和启动应用程序。
- 适用场景:适合开发单体应用或微服务的基础服务,通常是用来构建单个、独立的微服务。
- 核心组件:
- 自动配置 (
@EnableAutoConfiguration):简化配置 - Starter模块:提供常用的依赖集合,如
spring-boot-starter-web用于Web开发,spring-boot-starter-data-jpa用于JPA持久层开发 - Actuator:提供监控和管理功能
- 自动配置 (
2. Spring Cloud:
- 定义:Spring Cloud是基于Spring Boot,用于构建分布式系统和微服务架构的工具集。
- 功能:提供了微服务架构下的常用组件和解决方案,如服务注册与发现、负载均衡、分布式配置管理、熔断、网关、链路追踪等。
- 适用场景:适合开发和管理大规模的分布式系统,尤其是微服务架构。
- 核心组件:
- 服务发现(Eureka、Consul、Zookeeper)
- 配置管理(Spring Cloud Config)
- 负载均衡(Ribbon)
- 熔断器(Hystrix)
- 网关(Spring Cloud Gateway)
- 分布式追踪(Sleuth)
3. 关系:
- Spring Cloud依赖于Spring Boot提供的自动配置和模块化支持,通常基于Spring Boot进行服务的开发和管理。
- 使用方式:一般来说,Spring Boot用于开发具体的微服务,而Spring Cloud用于管理这些微服务之间的交互和通信。
总结:
- Spring Boot关注的是简化单个服务的开发,而Spring Cloud关注的是简化微服务架构的分布式管理。
- Spring Boot更适合构建单体或微服务的基础应用,而Spring Cloud则提供微服务架构中的高级组件支持,适合构建大规模分布式系统。
其他
 wechat
 alipay